Наличие резервной копии ещё не означает, что бизнес сможет возобновить работу. Данные в ней могут быть слишком старыми, а восстановление — занять больше времени, чем готовы ждать сотрудники и клиенты. Чтобы отдельно управлять этими ограничениями, компания устанавливает две цели: RPO для допустимой потери данных и RTO для времени восстановления.
Эти меры относятся к конкретному сервису или корпоративной системе. Определите их на основе последствий сбоя, а затем сравните их с возможностями ИТ. Успешное состояние резервной копии или обещание поставщика не гарантируют, что цели могут быть достигнуты.
Разделите потерю данных от простоев
Что такое RPO
Цель восстановления (Recovery Point Objective, или RPO) – это допустимый период потери недавних данных, выраженный в виде временного интервала. Вопрос, который должен задать владелец процесса: какие недавние изменения компания может потерять или восстановить из других источников без неприемлемых последствий?
RPO не измеряет размер файла. Один и тот же интервал может представлять несколько измененных документов или большое количество заказов. Помимо времени, необходимо фиксировать, какие именно данные изменяются, как часто, и можно ли надежно восстановить отсутствующие записи.
Что такое RTO
Цель восстановления (Recovery Time Objective, или RTO) определяет целевое время, необходимое для возврата системы или сервиса в согласованное состояние после сбоя. Определите это состояние заранее. Запущенная виртуальная машина еще не означает, что сотрудник сможет войти, открыть данные и выполнить необходимые операции.
AWS различает эти цели следующим образом: RTO ограничивает допустимую задержку в восстановлении сервиса, а RPO определяет допустимый интервал потери данных до сбоя. Организация определяет оба показателя для своих собственных процессов.
Цель и измеримый результат служат разным целям
|
Измерять |
Отвечает на этот вопрос |
Что нужно проверить |
|---|---|---|
|
RPO |
Насколько свежими должны быть сохраненные данные? |
Последний доступный и последовательный набор данных |
|
RTO |
Когда сервис должен снова быть доступен для выполнения согласованной работы? |
Время до проведения тестирования и принятия пользователями |
|
Фактический результат |
Что было достигнуто в конкретном тесте или инциденте? |
Временные метки, сохранение данных и действия, связанные с завершением работы |
Не путайте цель с результатом
Определите цель до возникновения сбоя. Измерьте фактическое восстановление после или во время теста. Если команда восстанавливает сервис медленнее, чем требуется, устраните эту проблему или обратитесь к владельцу бизнеса за решением. Не переименовывайте фактическое время восстановления как новый RTO и не объявляйте тест успешным.
Указанное среднее время восстановления, иногда называемое MTTR, также не заменяет RTO. Среднее значение описывает набор наблюдений. Оно может скрывать отдельные длительные сбои. Оценка цели требует результатов, полученных в соответствующих сценариях и при наличии причин отклонений.
Определите четкие границы измерения
Определите точку данных и время восстановления сервиса
Для оценки потерь данных сравните время сбоя с последней точкой, с которой фактически было восстановлено требуемое состояние. Используйте данные и транзакции в этой точке, а не только время начала выполнения резервного копирования. Неудачное выполнение, отставание в репликации или неконсистентная копия могут увеличить фактическую разницу. Рассмотрите гипотетический пример: сбой происходит в 12:00, последняя используемая точка содержит данные на 11:45, а операция восстановления подтверждается в 13:00. Разница в данных составляет 15 минут, а время простоя – один час. Сравните каждое значение со своей установленной целью. Это разные интервалы, даже если они измеряются в одних и тех же единицах.
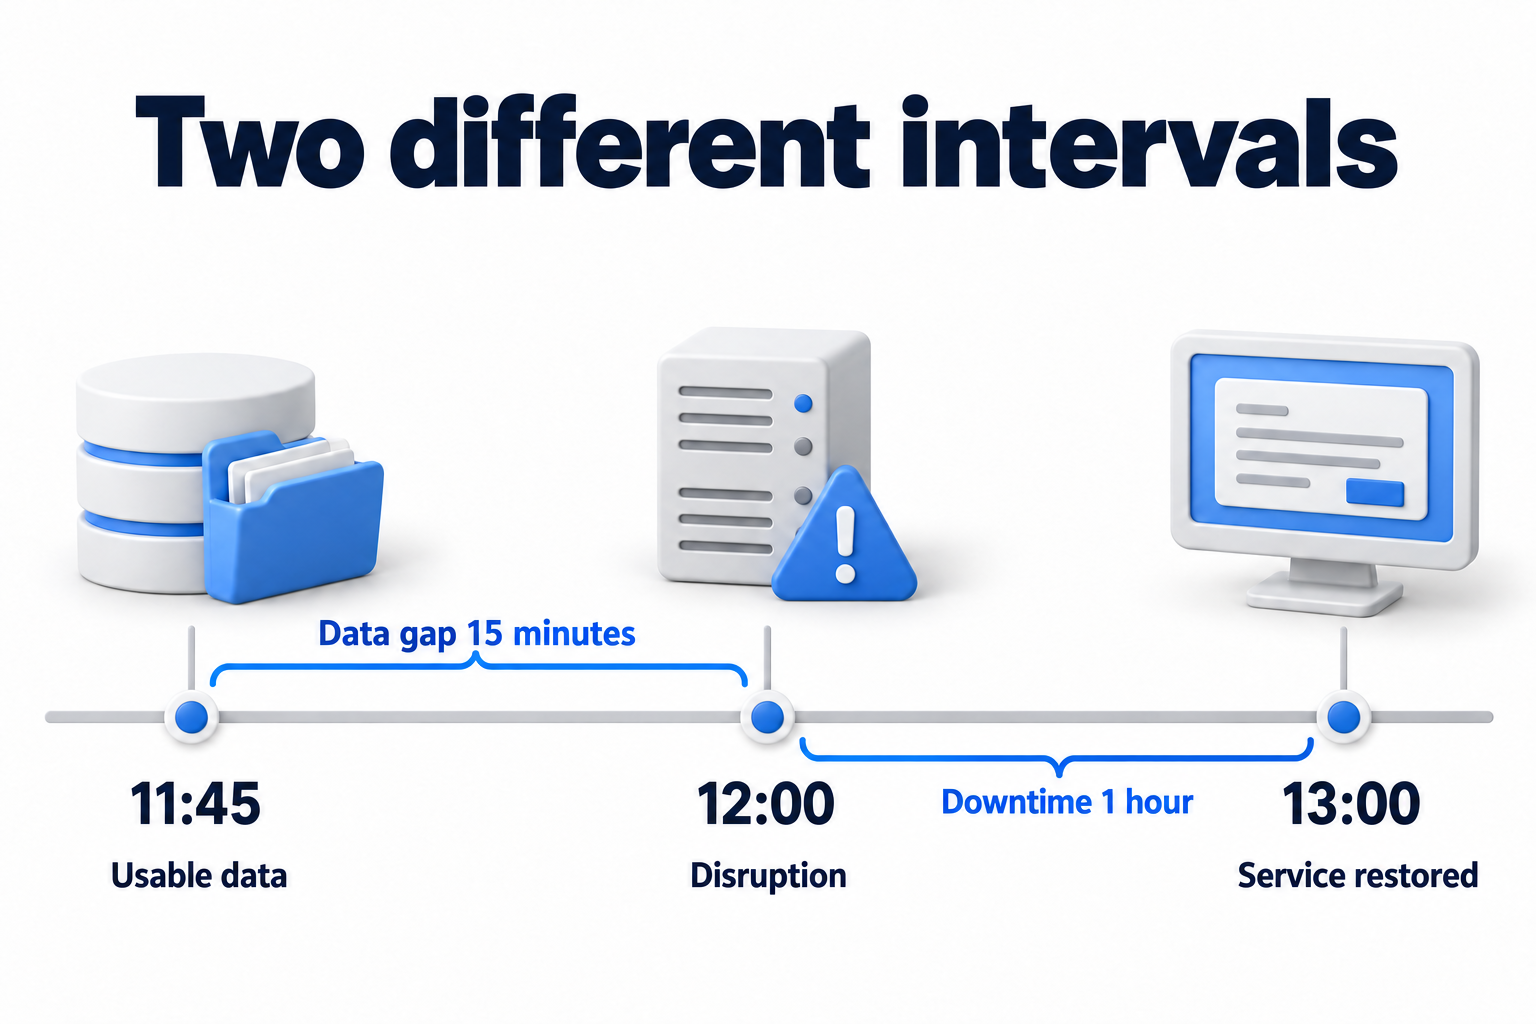
Для оценки времени простоя необходимо отсчитывать время от согласованного события сбоя до подтверждения доступности сервиса. Необходимо учитывать обнаружение, принятие решения о восстановлении, подготовку доступа и ресурсов, передачу данных, запуск зависимостей и проверку результатов. Любые исключенные периоды следует фиксировать явно, иначе команды будут сравнивать разные объемы.
В случае скрытой коррозии данных, последняя используемая точка может быть старше самой последней резервной копии. Таким образом, возраст самой последней операции не всегда отражает фактические потери. Во время тестирования необходимо убедиться, что выбранная версия содержит полезные данные, а не сохраненную ошибку.
Определите минимальный результат, который необходимо достичь.
Зафиксируйте конкретное действие, которое подтвердит восстановление. Например, для электронной почты это может быть вход и отправка сообщения. Для сервиса файлов важны необходимые папки и разрешения. Для бизнес-базы данных необходимы проверки данных и выполнение операций приложения, а не только доступность сервера. Согласуйте, допустимо ли временное ограничение функциональности.
Восстановление IT не всегда мгновенно восстанавливает весь процесс. После запуска команде может потребоваться сверка данных, обработка накопленных запросов и взаимодействие с бизнес-партнерами. Предусмотрите время для этих действий в общем плане обеспечения непрерывности. Не заменяйте время технического запуска допустимым временем простоя бизнес-процесса.
Согласуйте цели для каждой важной системы.
Начните с оценки бизнес-последствий.
Владелец процесса объясняет, что остановится во время сбоя, кто будет затронут и как последствия изменятся со временем. У платежной системы, внутренней архивной системы и системы подготовки документов будут разные ответы. Важность зависит от того, когда используется приложение, от обязательств и доступных обходных путей, а не только от его названия.
- Какие операции невозможно выполнить без этой системы?
- Какие данные появятся или изменятся между точками, доступными для восстановления?
- Можно ли восстановить отсутствующие изменения из проверенного источника, и сколько времени это займет?
- Существует ли согласованный временный процесс, и когда он перестанет работать?
- Какие внутренние или внешние обязательства влияют на допустимую потерю и сроки?
Не присваивайте цели, взятые из таблицы другой отрасли. Одна и та же система может поддерживать различные виды деятельности в разных компаниях. Проверьте применимые требования отдельно. Утверждение о том, что определенный закон устанавливает одинаковые значения RPO и RTO для каждой организации в отрасли, не заменяет эту работу.
Заполните матрицу целей
Скопируйте форму и заполните квадратные скобки решениями владельцев. Включайте не только конечные приложения, но и необходимые сервисы аутентификации, сети и способы доступа к резервным копиям.
Матрица целей без установленных сроков
|
Система |
Результат работы |
Допустимая потеря данных |
Допустимое время простоя |
Владелец решения |
Проверка осуществимости |
|---|---|---|---|---|---|
|
Корпоративная электронная почта |
[Логин и согласованные операции с электронной почтой] |
[Интервал и переписка, охватываемые сервисом] |
[Целевое время] |
[Владелец процесса] |
[Используемая точка, логин и проверка обмена электронной почтой] |
|
Рабочие файлы |
[Необходимые папки с соответствующими правами доступа] |
[Изменение интервала и метод сверки] |
[Целевое время] |
[Владелец данных] |
[Версия файла, доступ и действия] |
|
Основное приложение |
[Согласованная операция с использованием проверенных данных] |
[Интервал транзакции] |
[Целевое время] |
[Владелец приложения] |
[Последовательность зависимостей и принятие операций] |
Сохраните дату утверждения, сценарий отказа и ответственных за техническое тестирование. Если несколько приложений относятся к одной категории, они должны иметь совместимые последствия и зависимости при недоступности. Метки, такие как «критический уровень», не определяют допустимое время простоя самостоятельно.
Проверьте зависимости, затраты и ограничения
Восстановите сервис вместе с его окружением
Приложение может зависеть от каталога пользователей, DNS, сети, базы данных, сертификатов, ключей и внешних интеграций. Потеря любого необходимого соединения приводит к изменению результата. Проверьте порядок запуска и доступ команды к инструментам восстановления, особенно если стандартная корпоративная аутентификация недоступна.
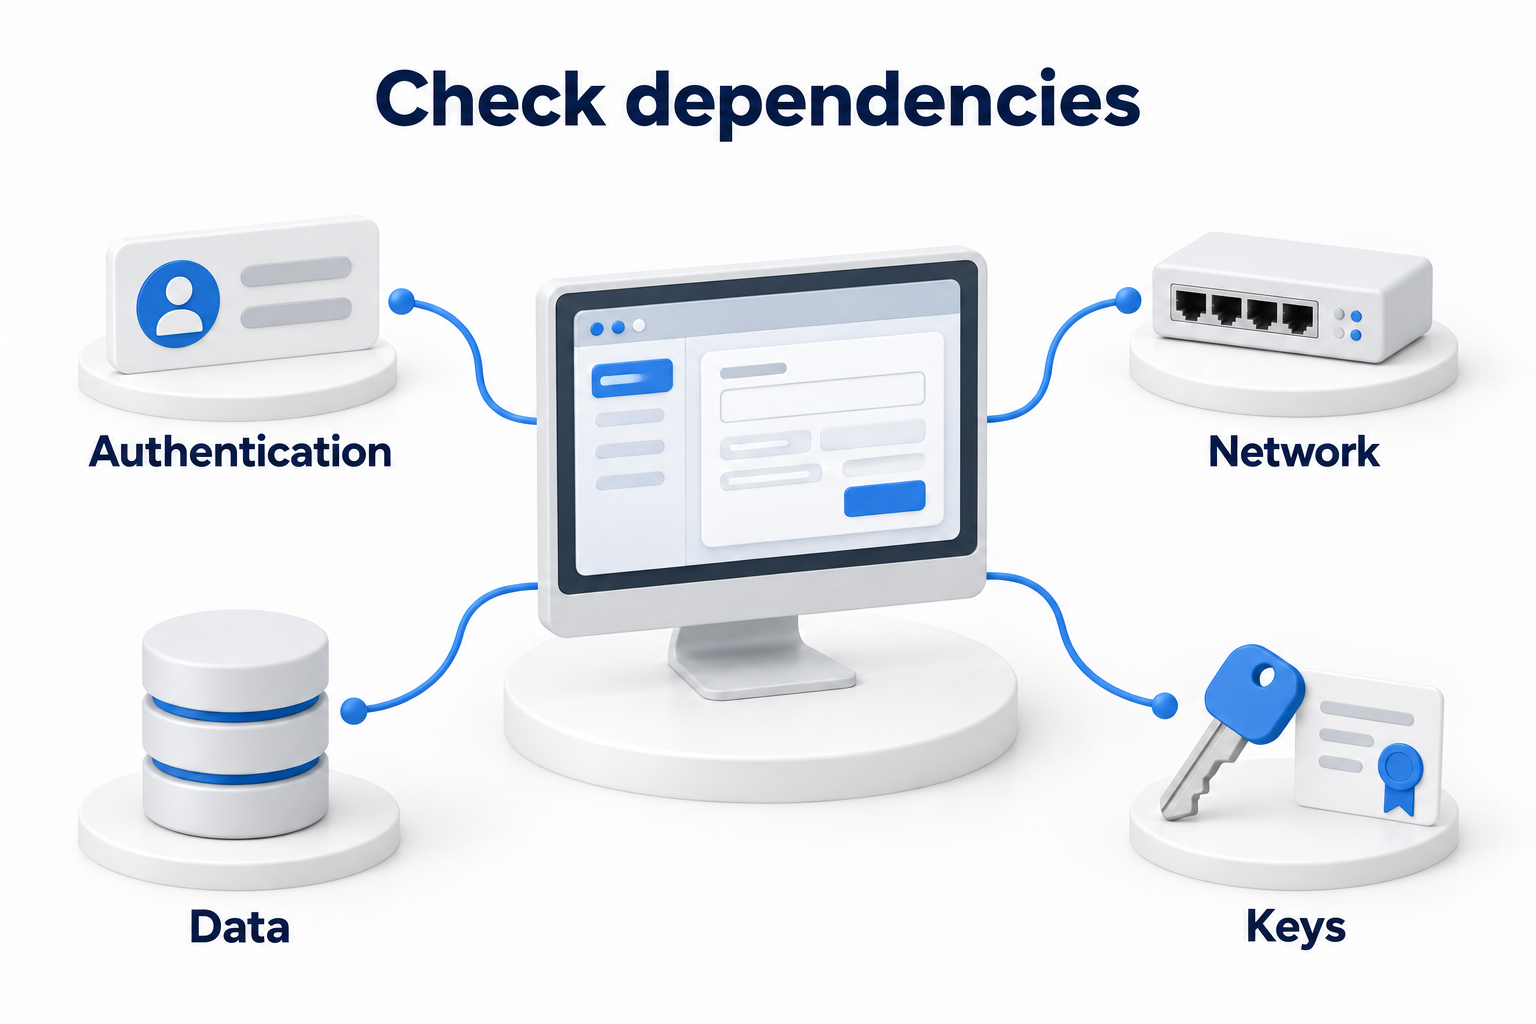
В облаке также проверьте доступность окружения, разрешения, квоты, ресурсы и механизмы восстановления для выбранной рабочей нагрузки. Для SaaS уточните объем охвата данных, доступные операции и ограничения сервиса. Скорость экспорта API, доступность ключей и пропускная способность соединения могут повлиять на результат. Общая доступность платформы не гарантирует, что конкретные данные или приложения будут восстановлены в течение выбранного времени.
Если процесс зависит от поставщика, сравните его обязательства и подтвержденные возможности с вашими целями. Предусмотрите время для связи с поставщиком, получения доступа и восстановления интеграции. Обещание одного поставщика не гарантирует, что оно полностью покрывает всю цепочку компании.
Сопоставьте требование с реализуемым вариантом
Более строгие цели могут потребовать дополнительных ресурсов, более частой защиты данных, подготовленной среды восстановления и регулярного тестирования. Сравните варианты по требуемому результату и общей стоимости поддержки. Не выбирайте самый короткий срок только для того, чтобы отчет выглядел хорошо.
Если подходящий вариант превышает доступные ресурсы, сообщите об этом руководству. Вы можете изменить объем восстановленной функции, улучшить технологию, подготовить временный процесс или согласовать другую цель. Владелец бизнеса решает, принимать риск или нет. IT не должно молча обещать недостижимый результат.
Нулевой RPO означает отсутствие потери защищаемых изменений в рамках согласованного сценария. Обозначение «непрерывное резервное копирование» этого не подтверждает. Проверьте сохранность зафиксированных транзакций, метод репликации, задержки связи и поведение при переключении на резервную систему. Минимальная потеря данных также не означает мгновенного восстановления сервиса: RPO и RTO остаются отдельными целями.
Проверьте цели через восстановление и поддерживайте их актуальными
Проверьте больше, чем график резервного копирования
График указывает на намерение, а не на доказательство. Для RPO проверьте возраст используемой точки и сохранность необходимых изменений. Для RTO измерьте время, необходимое для выполнения действия пользователя. Сохраняйте условия тестирования: объем данных, доступные ресурсы, сценарий и зависимости. Без них невозможно правильно сравнить следующий результат.
Документация AWS рекомендует тестирование реализации восстановления и поддержание актуальной конфигурации среды восстановления. Изменения в объеме данных, квотах или ресурсах могут сделать предыдущие предположения недействительными.
Резервирование, репликация и автоматизация могут помочь, но не доказывают независимо, что цель может быть достигнута. Репликация может содержать ошибочные изменения. Восстановление данных из защищенной копии может занять время. Оцените успешное автоматизированное тестирование по его охвату, а не как доказательство против всех возможных сбоев.
Фиксируйте отклонения и пересматривайте решение
Если целевое значение превышено, запишите причину, ответственного за исправление и срок повторного тестирования. Если зависимость вызвала задержку, не фокусируйтесь только на ускорении загрузки резервной копии. Исправление должно сократить этап, который на самом деле привел к задержке.
Пересматривайте цели и доказательства после существенных изменений: новое приложение, рост данных, изменение провайдера, изменение процесса или инцидент. Также установите дату запланированного пересмотра условий для вашей компании. Рекомендация другой организации проводить тестирование ежеквартально не создает обязательный график для каждой среды.
Для завершения обсуждения необходимо утвержденная матрица, четкие границы измерения, проверенные зависимости и недавний результат восстановления. RPO и RTO затем становятся практическими критериями для выбора изменений и принятия решений, а не просто двумя аббревиатурами в контракте.
Нужно сопоставить цели с вашей системой резервного копирования? Обратитесь в DKs Enterprises по вопросам резервного копирования и аварийного восстановления. Подготовьте список важных сервисов, их зависимостей и результатов последних тестов, чтобы обсудить необходимые работы.