Un backup può esistere anche quando l’azienda non riesce ancora a riprendere il lavoro. I dati possono essere troppo vecchi, oppure il ripristino può richiedere più tempo di quanto dipendenti e clienti possano attendere. Per gestire separatamente questi limiti, l’azienda definisce due obiettivi: RPO per la perdita di dati e RTO per il tempo di ripristino.
Queste misure si applicano a un servizio o a un sistema aziendale specifico. Definite le conseguenze di un’interruzione, quindi confrontatele con le capacità IT. Un backup riuscito o una promessa del fornitore non garantiscono automaticamente che gli obiettivi possano essere raggiunti.
Distinguere la perdita di dati dal tempo di inattività
Che cosa significa RPO
L’obiettivo di ripristino (RPO), o Punto di Ripristino, esprime la perdita accettabile di dati recenti come un intervallo di tempo. La domanda per il responsabile del processo è: quali modifiche recenti potrebbe perdere o ricostruire l’azienda da altre fonti senza conseguenze inaccettabili?
L’RPO non misura la dimensione dei file. Lo stesso intervallo potrebbe rappresentare alcuni documenti modificati o molte ordinazioni. Oltre al tempo, registrare quali informazioni cambiano, con quale frequenza e se è possibile ricostruire in modo affidabile i record mancanti.
Che cosa significa RTO
L’obiettivo di ripristino (RTO), o Tempo di Ripristino, definisce il tempo target per riportare un sistema o un servizio a uno stato operativo concordato dopo un’interruzione. Definire questo stato in anticipo. Una macchina virtuale in esecuzione non significa necessariamente che un dipendente possa effettuare il login, aprire i dati e eseguire l’operazione richiesta.
AWS distingue questi obiettivi come segue: l’RTO limita il ritardo accettabile nel ripristino di un servizio, mentre l’RPO definisce l’intervallo accettabile di perdita di dati prima dell’interruzione. L’organizzazione definisce entrambi gli obiettivi per i propri processi.
Un obiettivo e un risultato misurato hanno scopi diversi.
|
Misura |
Domanda a cui risponde |
Che cosa verificare |
|---|---|---|
|
RPO |
Quanto devono essere recenti i dati conservati? |
Il punto dati più recente utilizzabile e coerente |
|
RTO |
Quando deve tornare disponibile il servizio per le attività concordate? |
Tempo fino alla verifica e all’accettazione da parte degli utenti |
|
Risultato effettivo |
Che cosa si è ottenuto in una specifica prova o in un incidente? |
Riferimenti temporali, conservazione dei dati e attività completate |
Non confondere l’obiettivo con il risultato
Definire l’obiettivo prima di un’interruzione. Misurare il tempo di ripristino effettivo successivamente o durante un test. Se il team impiega più tempo del previsto per ripristinare il servizio, intervenire per colmare il divario o chiedere al responsabile del business di prendere una decisione. Non retroattivamente definire la durata effettiva come nuovo tempo di ripristino (RTO) e dichiarare il test come positivo.
Anche un tempo medio di ripristino riportato, a volte chiamato MTTR (Mean Time To Recovery), non sostituisce l’RTO. Un valore medio descrive un insieme di osservazioni. Può nascondere interruzioni individuali prolungate. Valutare l’obiettivo richiede risultati da scenari pertinenti e ragioni per le deviazioni.
Definire chiaramente i confini della misurazione
Identificare il punto dati e il momento del ritorno del servizio
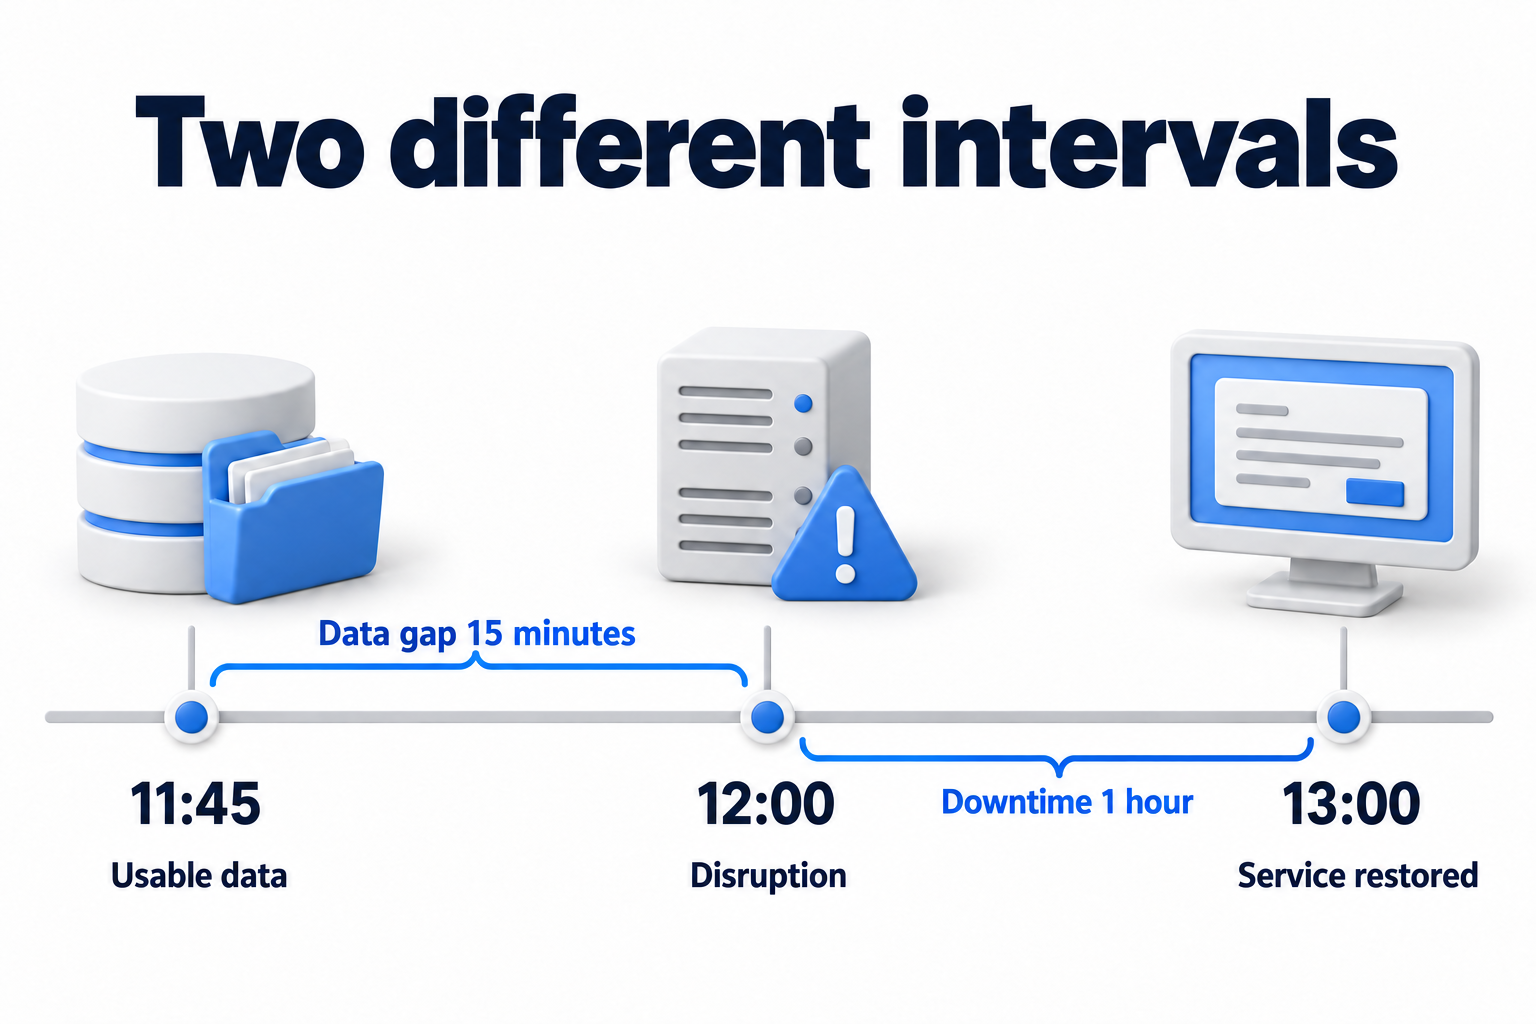
Per valutare la perdita di dati, confrontare il tempo di interruzione con l’ultimo punto da cui è stato effettivamente ripristinato lo stato desiderato. Utilizzare i dati e le transazioni in quel punto, non solo l’ora di inizio del backup. Un backup fallito, un ritardo nella replicazione o una copia incoerente possono aumentare il divario effettivo. Considerare un esempio ipotetico: l’interruzione avviene alle 12:00, l’ultimo punto utilizzabile contiene dati aggiornati alle 11:45 e l’operazione di ripristino viene confermata alle 13:00. Il divario di dati è di 15 minuti e il tempo di inattività è di un’ora. Confrontare ogni valore con il suo obiettivo approvato. Si tratta di intervalli diversi, anche quando misurati nelle stesse unità.
Per valutare il tempo di inattività, contare dall’evento di interruzione concordato fino alla conferma della disponibilità del servizio. Includere il rilevamento, la decisione di ripristino, l’accesso e la preparazione delle risorse, il trasferimento dei dati, l’avvio delle dipendenze e la verifica dei risultati. Registrare esplicitamente qualsiasi tempo escluso, altrimenti i team confronteranno quantità diverse.
In caso di corruzione dei dati nascosta, il punto più recente utilizzabile potrebbe essere più vecchio dell’ultimo backup. L’età dell’ultimo job non mostra sempre la perdita effettiva. Durante i test, verificare che la versione scelta contenga dati utilizzabili piuttosto che un errore salvato.
Definire il risultato operativo minimo
Registrare un’azione specifica che confermi il ripristino. Per le e-mail, potrebbe essere l’accesso e l’invio di un messaggio. Per un servizio di file, sono importanti le cartelle e le autorizzazioni richieste. Un database aziendale richiede controlli dei dati e un’operazione di applicazione, non solo la disponibilità del server. Concordare se la funzionalità temporaneamente limitata è accettabile.
Il ripristino dell’IT non ripristina sempre l’intero processo immediatamente. Dopo l’avvio, il team potrebbe dover confrontare i record, gestire le richieste accumulate e contattare i partner aziendali. Prevedere tempo per queste azioni nel piano di continuità più ampio. Non sostituire il tempo di avvio tecnico con il tempo di inattività accettabile del processo aziendale.
Concordare gli obiettivi per ciascun sistema importante
Partire dalle conseguenze per l’azienda
Il responsabile del processo spiega cosa si interromperà in caso di guasto, chi ne sarà colpito e come le conseguenze cambiano nel tempo. Un servizio di pagamento, un archivio interno e un sistema di preparazione dei documenti avranno risposte diverse. L’importanza dipende da quando l’applicazione viene utilizzata, dagli obblighi e dalle soluzioni alternative disponibili, non solo dal suo nome.
- Quali operazioni non si possono svolgere senza questo sistema?
- Quali dati vengono creati o modificati tra due punti di ripristino utilizzabili?
- È possibile ricreare le modifiche mancanti da una fonte verificata, e quanto lavoro richiederà?
- Esiste un processo temporaneo concordato, e quando terminerà?
- Quali obblighi interni o esterni influenzano l’accettabile livello di perdita e i tempi?
Non attribuire obiettivi basati su tabelle di un’altra industria. Lo stesso sistema può supportare diverse attività in diverse aziende. Verificare i requisiti applicabili separatamente. L’affermazione che una specifica legge stabilisca lo stesso RPO e RTO per ogni organizzazione in un settore non sostituisce questo lavoro.
Compilare la matrice degli obiettivi
Copiare il modulo e riempire le parentesi quadre con le decisioni dei proprietari. Includere non solo le applicazioni finali, ma anche i servizi di autenticazione, le reti e i metodi per accedere ai backup.
Matrice degli obiettivi senza scadenze prestabilite
|
Sistema |
Risultato operativo |
Perdita di dati accettabile |
Tempo di inattività accettabile |
Responsabile della decisione |
Verifica di fattibilità |
|---|---|---|---|---|---|
|
Posta aziendale |
[Accesso e operazioni di posta concordate] |
[Intervallo e corrispondenza coperta] |
[Tempo obiettivo] |
[Responsabile del processo] |
[Punto utilizzabile, accesso e prova di scambio di messaggi] |
|
File di lavoro |
[Cartelle necessarie con autorizzazioni corrette] |
[Intervallo delle modifiche e metodo di riconciliazione] |
[Tempo obiettivo] |
[Responsabile dei dati] |
[Versione del file, accesso e operazione di lavoro] |
|
Applicazione principale |
[Operazione concordata con dati verificati] |
[Intervallo delle transazioni] |
[Tempo obiettivo] |
[Responsabile dell’applicazione] |
[Sequenza delle dipendenze e accettazione dell’operazione] |
Mantenere la data di approvazione, lo scenario di fallimento e i responsabili dei test tecnici. Se più applicazioni condividono una categoria, devono avere conseguenze e dipendenze di downtime compatibili. Etichette come “livello critico” non definiscono automaticamente i minuti accettabili.
Verificare dipendenze, costi e limiti
Ripristinare il servizio insieme al suo ambiente
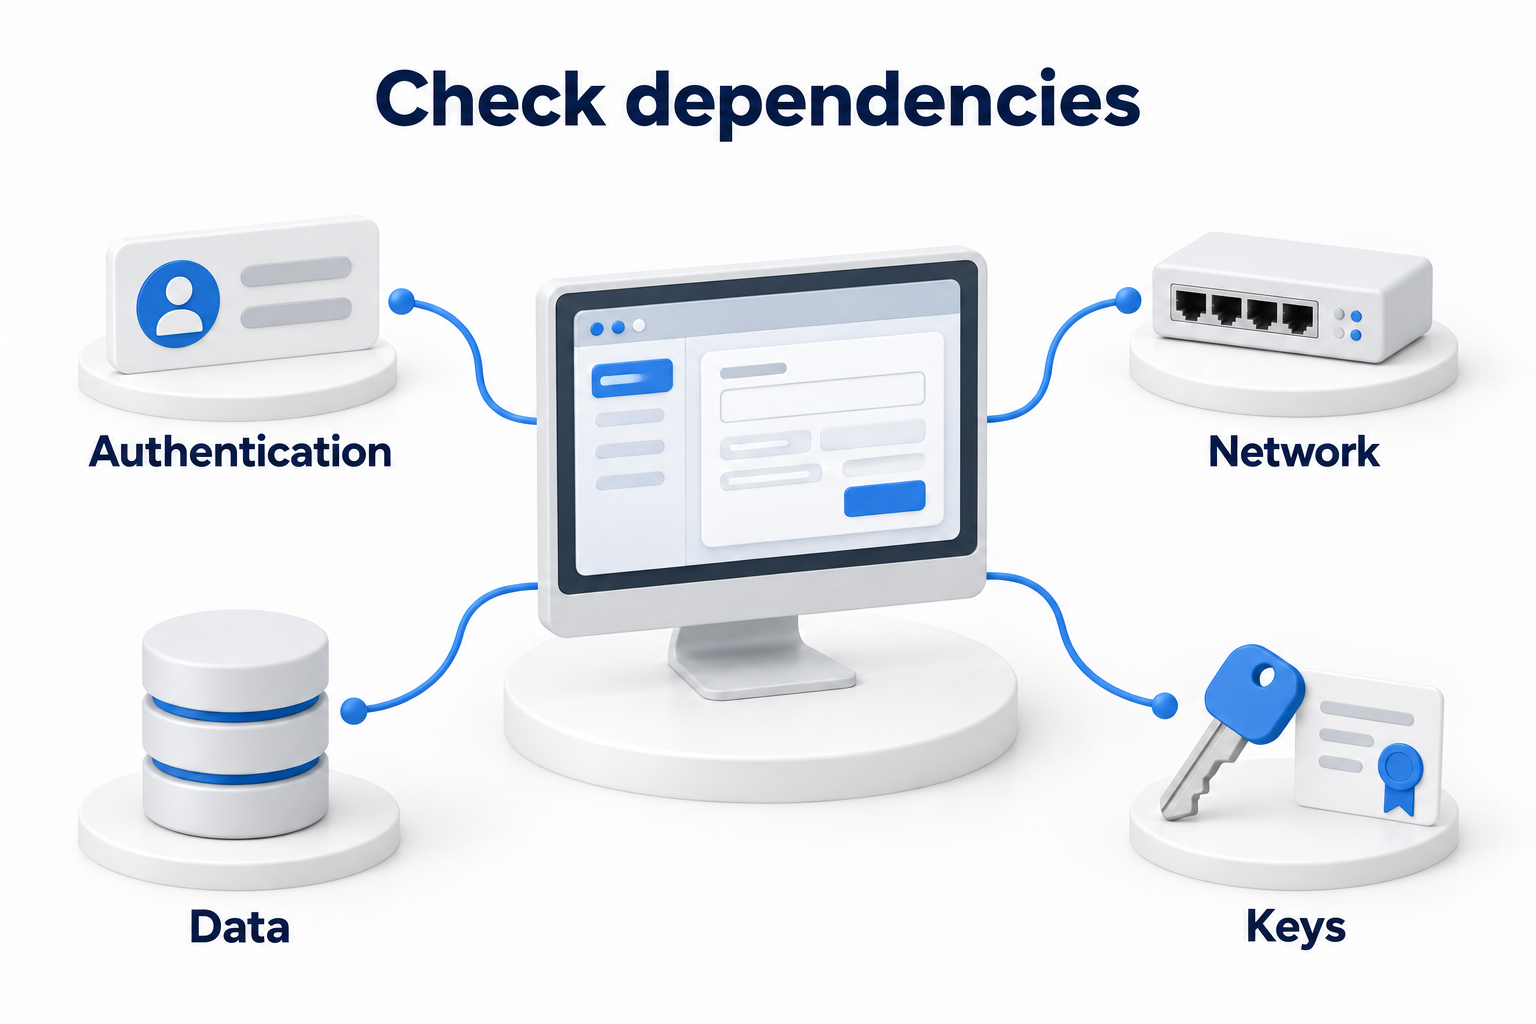
Un’applicazione può dipendere da un dizionario utenti, DNS, la rete, un database, certificati, chiavi e integrazioni esterne. La perdita di qualsiasi collegamento necessario modifica il risultato. Verificare l’ordine di avvio e l’accesso del team agli strumenti di ripristino, soprattutto se l’autenticazione aziendale standard non è disponibile.
Nel cloud, verificare anche la disponibilità dell’ambiente, i permessi, i limiti, le risorse e i meccanismi di ripristino per il carico di lavoro selezionato. Per SaaS, chiarire la copertura dei dati, le operazioni disponibili e i limiti del servizio. La velocità di esportazione API, la disponibilità delle chiavi e la larghezza di banda della connessione possono modificare il risultato. La disponibilità generale della piattaforma non dimostra che dati o applicazioni specifici si ripristineranno entro il tempo scelto.
Se il processo dipende da un fornitore, confrontare i suoi impegni e le capacità verificate con i propri obiettivi. Prevedere tempo per contattare il fornitore, ottenere l’accesso e ripristinare l’integrazione. La promessa di un singolo fornitore non copre automaticamente l’intera catena aziendale.
Associare il requisito a una soluzione fattibile
Obiettivi più stringenti potrebbero richiedere risorse aggiuntive, una protezione dei dati più frequente, un ambiente di ripristino predisposto e test regolari. Confrontare le opzioni in base al risultato desiderato e al costo totale del supporto. Non scegliere l’opzione più breve solo per rendere un report più attraente.
Se un’opzione adeguata supera le risorse disponibili, informare la direzione sulla situazione. È possibile modificare lo scopo della funzione di ripristino, migliorare la tecnologia, preparare un processo temporaneo o concordare un altro obiettivo. Il proprietario dell’attività decide se accettare il rischio. L’IT non deve promettere silenziosamente un risultato irraggiungibile.
Un RPO pari a zero significa nessuna perdita delle modifiche protette nello scenario concordato. La dicitura «backup continuo» non lo conferma. Verificate la conservazione delle transazioni confermate, il metodo di replica, i ritardi di comunicazione e il comportamento durante il failover. Una perdita minima di dati non implica un ripristino istantaneo del servizio: RPO e RTO restano obiettivi distinti.
Convalidare gli obiettivi mediante il ripristino e mantenerli aggiornati
Non limitarsi a verificare la pianificazione dei backup
Un programma indica un’intenzione, non una prova. Per RPO, verificare l’età del punto di ripristino e la conservazione delle modifiche richieste. Per RTO, misurare il percorso per un’azione dell’utente. Mantenere le condizioni di test: volume dei dati, risorse disponibili, scenario e dipendenze. Senza di esse, il risultato successivo non può essere confrontato correttamente.
La documentazione di AWS raccomanda di testare l’implementazione del ripristino e di mantenere aggiornata la configurazione dell’ambiente di ripristino. Cambiamenti nel volume dei dati, nelle quote o nelle risorse possono invalidare le assunzioni precedenti.
Ridondanza, replicazione e automazione possono aiutare, ma non dimostrano in modo indipendente che un obiettivo può essere raggiunto. La replicazione può contenere modifiche errate. Recuperare i dati da una copia protetta può richiedere tempo. Valutare un test automatizzato di successo in base alla sua copertura piuttosto che trattarlo come prova contro ogni possibile guasto.
Registrare gli scostamenti e rivedere la decisione
Se un obiettivo viene superato, registrare la causa, l’ente responsabile della risoluzione e la scadenza per il ripristino. Se una dipendenza ha causato il ritardo, non concentrarsi solo sull’aumento della velocità di caricamento del backup. La soluzione dovrebbe accorciare la fase che ha effettivamente ritardato il risultato.
Rivedere obiettivi ed evidenze dopo modifiche significative: una nuova applicazione, una crescita dei dati, un cambiamento del fornitore, un cambiamento del processo o un incidente. Stabilire anche una data di revisione programmata per le condizioni della propria azienda. La raccomandazione di un’altra organizzazione di testare tutto ogni trimestre non crea un programma obbligatorio per ogni ambiente.
Per completare la discussione, è necessario un matrice approvata, confini di misurazione chiari, dipendenze verificate e un recente risultato di ripristino. RPO e RTO diventano quindi criteri pratici per la selezione delle modifiche e il processo decisionale, piuttosto che semplici acronimi in un contratto.
Avete bisogno di confrontare gli obiettivi con il vostro sistema di backup? Contattate DKs Enterprises per soluzioni di backup e ripristino. Preparate un elenco dei servizi importanti, delle loro dipendenze e dei risultati dei test recenti per discutere del lavoro necessario.