Un rapporto può contenere centinaia di rilievi, mentre il team riesce a verificarne e risolverne solo una parte in un ciclo di lavoro. Ordinare i risultati per punteggio più alto non spiega che cosa minaccia l’azienda in questo momento. Per creare una coda di interventi utile occorre confermare l’applicabilità, valutare l’accessibilità del percorso di attacco e collegare le conseguenze al ruolo del sistema.
La priorità inizia con le vulnerabilità già individuate. Produce una lista di decisioni: cosa riparare per primo, dove è necessario un controllo temporaneo, quali informazioni devono ancora essere verificate e chi è responsabile di ciascuna azione. Una valutazione generale del rischio informatico ha una portata più ampia, coprendo processi e scenari. Questo articolo si concentra sulla coda di problemi tecnici.
Preparare risultati affidabili
Consolidare i risultati della valutazione attorno a un identificatore di asset e a un problema in un componente specifico. Conservare la fonte, la data di scoperta, la versione del componente e le prove. La stessa CVE su diversi server può avere priorità diverse. Molteplici segnalazioni relative a una singola istanza non dovrebbero diventare attività indipendenti. Una causa comune, come un’immagine di base del container, può comunque portare a collaborare molte istanze.
Verificare se il prodotto, la versione e la configurazione sono effettivamente interessati. Utilizzare il bollettino del fornitore e le informazioni di sistema verificate. L’assenza di un numero CVE non rende un errore di configurazione sicuro. L’assenza di un componente o di una piattaforma incompatibile può dimostrare che una vulnerabilità non si applica. L’implementazione interna o l’uso occasionale da solo non sono sufficienti. Assegnare un’attività contestata a un proprietario e a una scadenza.
Registrare se la condizione vulnerabile è raggiungibile separatamente. Per un’applicazione, stabilire se il codice interessato è in esecuzione e con quali dati o permessi. Per un server, stabilire chi può connettersi al servizio pertinente. La raggiungibilità del codice e l’esposizione a Internet descrivono condizioni diverse e non si sostituiscono a vicenda. Se una regola di rete blocca il percorso corrente, verificare i percorsi interni e la possibilità di modificare quella regola. Una affermazione secondo cui qualcosa non viene utilizzato richiede prove e una data di revisione.
Distinguere gravità, sfruttamento e previsione
|
Indicatore |
Che cosa mostra |
Che cosa non dimostra |
|---|---|---|
|
CVSS |
Caratteristiche tecniche e livello di gravità. Conservare la versione, il punteggio e il vettore, ove disponibili. |
Un punteggio base non riflette la piena urgenza per la vostra organizzazione. Non combinare punteggi provenienti da versioni diverse senza considerare le loro differenze. |
|
KEV |
Il catalogo CISA contiene vulnerabilità con exploit confermati in attacchi reali. |
Un record non dimostra che la vostra istanza sia interessata o già compromessa. L’assenza dal catalogo non dimostra la sicurezza. |
|
EPSS |
Una stima aggiornata quotidianamente della probabilità che l’utilizzo di una CVE pubblicata venga osservato in attacchi reali entro i prossimi 30 giorni. |
Non si tratta della probabilità che la vostra azienda venga attaccata o di una misura dei danni. Un percentile mostra la posizione di un punteggio rispetto ad altri punteggi, non una probabilità. |
|
SSVC |
Un albero decisionale collega i fatti e il contesto dello stakeholder selezionato a un’azione per affrontare una vulnerabilità. |
Non si tratta di un altro punteggio di gravità o di un insieme universale di scadenze per ogni organizzazione. |
È possibile raffinare il CVSS utilizzando informazioni sulle minacce e sull’ambiente in conformità con le regole della versione selezionata. Nella versione 4.0, le metriche supplementari forniscono contesto, ma non modificano il punteggio finale. Confrontare le voci con una fonte di punteggio chiara e prendere decisioni insieme ai dati sull’ambiente.
Non moltiplicare il CVSS per l’EPSS per creare un valore di rischio presunto di precisione. Le scale descrivono quantità diverse. Un basso EPSS non annulla l’exploit già confermato nel KEV. Un attacco pubblico dimostrato, l’uso reale in attacchi e segni di un attacco all’interno dell’azienda sono diversi. L’ultimo di questi richiede una risposta agli incidenti insieme alla correzione della vulnerabilità.
Se si utilizza SSVC, selezionare un albero appropriato al proprio ruolo e conservare la sua versione, le risposte e le motivazioni. Discutere l’impatto tecnico e le conseguenze operative con il proprietario del sistema. Un percorso di decisione comprensibile è utile. Copiare le etichette di urgenza di qualcun altro senza collegarle ad azioni interne non è.
Chiarire le conseguenze e i limiti effettivi della protezione
- Scopo e proprietario dell’asset: quali operazioni e dati dipendono dal sistema e se esiste un’alternativa funzionante.
- Accessibilità: internet, rete interna, partner, amministrazione remota e credenziali richieste.
- Possibile esito dell’attacco: lettura dei dati, modifica dei record, interruzione di un servizio, espansione dei privilegi o accesso ad altri sistemi.
- Controlli esistenti: restrizioni di connessione, disabilitazione di una funzionalità, isolamento, filtraggio e rilevamento. Documentare la copertura e le prove dell’efficacia rispetto al percorso pertinente.
- Dipendenze di correzione: fornitore, libreria, immagine di base, compatibilità dell’applicazione, requisiti di riavvio e finestra di lavoro disponibile.
Non ridurre la priorità semplicemente perché un dispositivo ha installato software di sicurezza o opera su una rete interna. Un controllo deve bloccare la specifica condizione di sfruttamento e agire sull’asset pertinente. Rilevare un attacco e prevenirne l’esecuzione hanno effetti diversi. In assenza di prove sufficienti, registrare l’incertezza e un breve compito di verifica invece di un’esclusione non supportata.

Creare una matrice operativa delle priorità
Le seguenti regole sono esempi per la discussione interna. Non rappresentano uno standard del settore o un tempo di risoluzione garantito. L’organizzazione definisce i propri livelli, scadenze e autorità. Un’entrata reale deve includere una data, un responsabile e una spiegazione della decisione.
|
Condizioni del rilievo |
Decisione e motivazione |
Responsabile e scadenza |
Evidenze per la chiusura |
|---|---|---|---|
|
Esistono segnali di sfruttamento nel proprio ambiente. |
Segnalare immediatamente secondo il piano di risposta. Parallelamente, identificare un modo sicuro per limitare l’impatto. L’installazione di un aggiornamento standard non è sufficiente. |
Assegnare un coordinatore di incidenti e il proprietario del sistema; concordare le azioni e i tempi durante la risposta. |
Le prove sono state conservate, le azioni correttive concordate sono state completate e la risoluzione del problema è stata verificata. |
|
È stata confermata l’exploit in KEV, e il servizio interessato è accessibile esternamente ed è fondamentale per le operazioni. |
Dare priorità alla verifica e alla risoluzione rapida o, in alternativa, bloccare temporaneamente il percorso. Motivo: l’applicabilità, l’accessibilità e le conseguenze sono state confermate. |
Nominare un responsabile; un proprietario autorizzato definisce la data in base al rischio e a un periodo di lavoro sicuro. |
È stata verificata la versione o la configurazione, la condizione precedente di exploit e il funzionamento del servizio. |
|
La gravità tecnica è alta, ma la funzione interessata è disabilitata e la restrizione è stata verificata. |
Pianificare la risoluzione e monitorare la restrizione. Il punteggio elevato rimane, ma le condizioni attuali informano la decisione. |
Proprietario dell’asset; una data per la risoluzione e una data separata per verificare la restrizione. |
Lo stato della funzione, l’assenza di un bypass e il risultato della correzione pianificata sono stati confermati. |
|
Esiste un componente in una libreria condivisa o in un’immagine utilizzata da molti sistemi. |
Concentrarsi sulla risoluzione della causa principale, mantenendo al contempo l’elenco degli istanze interessate e delle loro diverse condizioni di esposizione. |
Proprietario della libreria o dell’immagine; una data di implementazione concordata per i sistemi dipendenti. |
L’immagine di origine non è l’unica cosa aggiornata: vengono create nuove istanze e vengono controllate o dismesse quelle esistenti. |
|
Applicabilità o accessibilità restano sconosciute. |
Verificare prima le informazioni. Non chiudere la segnalazione o presentare un’ipotesi come a basso rischio. |
Assegnare un revisore, con una data di risposta specifica e un processo di escalation per i ritardi. |
Le prove confermano l’applicabilità o supportano la chiusura della segnalazione, con data e autore. |
All’interno della coda, conservare l’ID della segnalazione, l’ID dell’asset, la fonte, il CVE (se disponibile), la gravità tecnica, le prove di sfruttamento e la data. Aggiungere informazioni sull’accessibilità, la criticità, i controlli verificati, la priorità selezionata, la motivazione, l’azione, l’implementatore, la scadenza, lo stato e un collegamento alle prove. Collegare l’entrata al ticket di modifica in modo che l’aggiornamento della coda non richieda corrispondenze manuali separate.
Quando più attività condividono una priorità, confrontare l’impatto, le dipendenze e le opportunità per eliminare una causa comune. Lo sforzo aiuta a pianificare il lavoro, ma non trasforma un problema complesso e pericoloso in uno sicuro. La risoluzione rapida di più piccole segnalazioni non dovrebbe spostare un’attività critica solo per migliorare il conteggio delle chiusure.
Assegnare un intervento sicuro anche senza una patch disponibile
La mancanza di un aggiornamento non significa che il problema debba rimanere in cima alla coda. Verificare le raccomandazioni del fornitore: è possibile limitare l’accesso, disabilitare la funzione interessata, isolare il sistema o sostituire un componente non supportato? Concordare ogni restrizione con il responsabile del processo e verificarne l’effetto. Se non esiste un metodo accettabile, un responsabile autorizzato deve decidere se il servizio può rimanere in uso.
Per un’attività differita, registrare il motivo, il rischio residuo, l’approvatore, il controllo temporaneo, la scadenza dell’eccezione e la data di revisione. L’accettazione del rischio non è un falso positivo. Un sistema legacy non supportato necessita di una decisione di sostituzione o dismissione, piuttosto che di estensioni infinite dello stato successivo.
Prima di apportare una modifica, verificare la compatibilità e preparare il backup necessario e un modo per ripristinare le impostazioni. Iniziare con un ambiente di test concordato o un gruppo limitato, testare l’applicazione e solo allora espandere il deployment. Un cambiamento urgente può accelerare il processo concordato, ma comunque richiede un responsabile e condizioni di arresto e ripristino. L’automazione deve seguire le regole approvate piuttosto che modificare tutti i sistemi critici senza controllo.
Definire scadenze interne utilizzando fatti, conseguenze e obblighi applicabili. Le scadenze di remediation di CISA si applicano alle organizzazioni specificate nelle direttive pertinenti. Non diventano automaticamente legge per un’azienda privata. Non assegnare a ogni segnalazione con lo stesso punteggio una scadenza identica senza verificare le condizioni e i requisiti contrattuali. Escalare i ritardi al responsabile del rischio invece di spostare semplicemente la data.
Verificare le correzioni e rivedere la coda
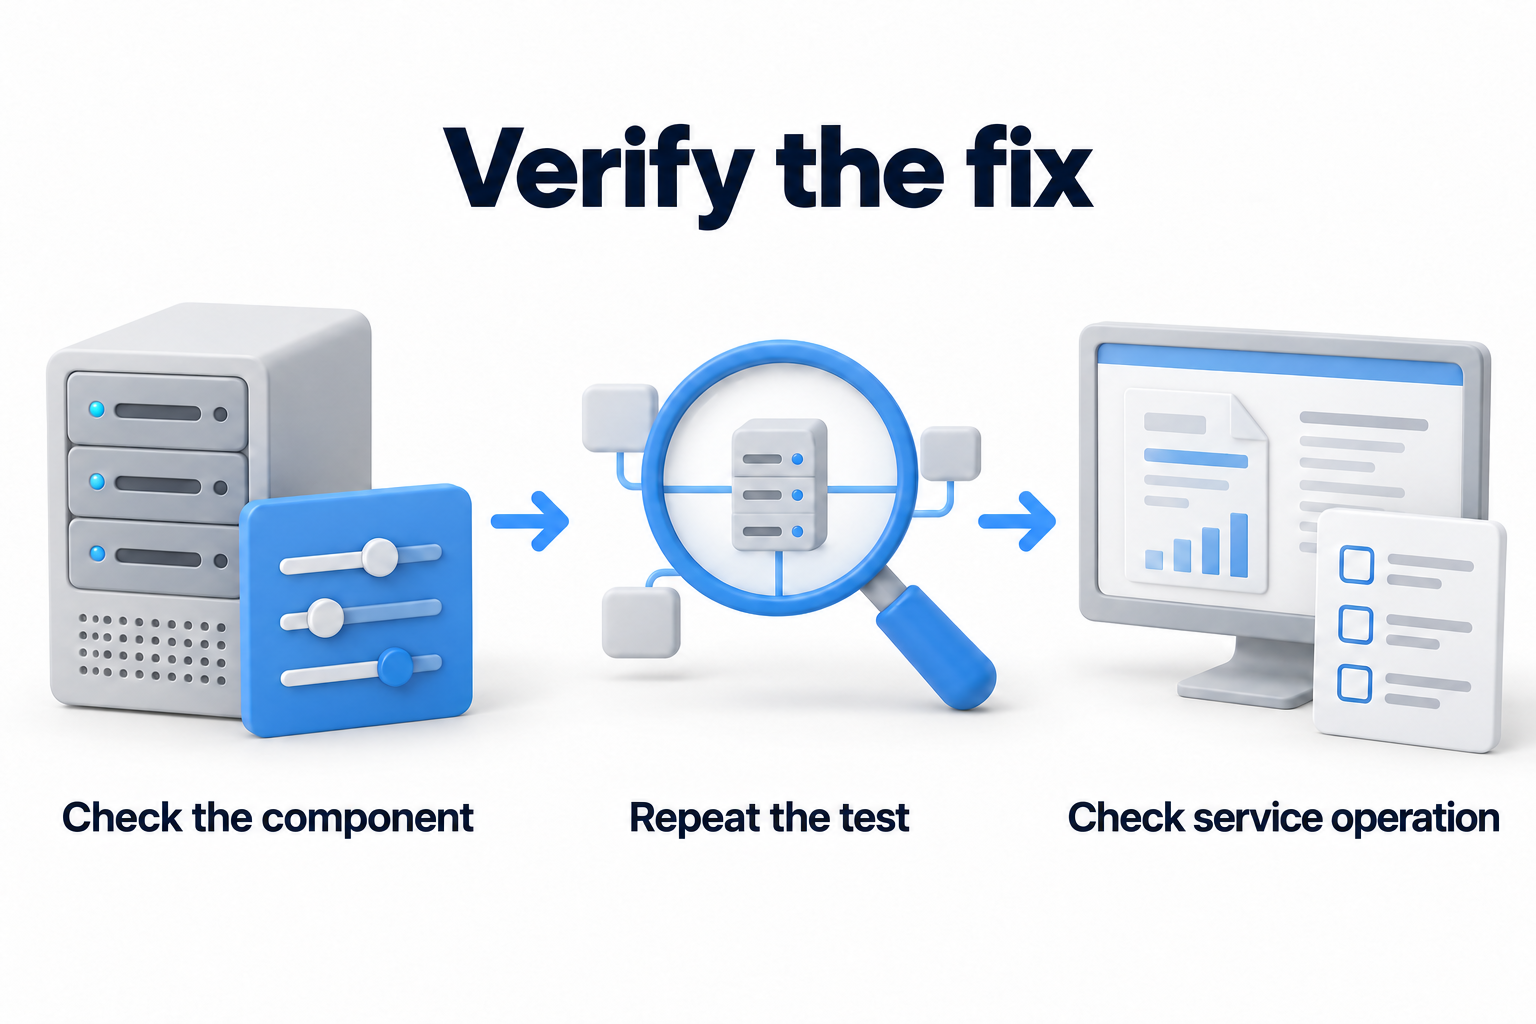
L’installazione di un aggiornamento non dimostra ancora la risoluzione. Verificare lo stato effettivo del componente nelle istanze pertinenti, ripetere in modo sicuro il controllo delle condizioni precedenti e confermare che il processo aziendale funzioni ancora. Cercare immagini obsolete, dispositivi spenti o un secondo nodo di servizio che potrebbe rimanere attivo. Aggiungere i dettagli e i risultati alla voce.
Aggiornare la priorità quando cambiano le evidenze di sfruttamento, EPSS, l’accessibilità del servizio, il ruolo dell’asset o l’efficacia di una restrizione. Conservare la data e la motivazione per una decisione rivista. Programmare regolarmente la riconciliazione delle code e una risposta separata ai nuovi segnali importanti. Se una fonte di valutazione non copre più un asset, ciò rappresenta una lacuna nel monitoraggio, non una prova di risoluzione.
Mostrare agli utenti più del numero di risultati risolti. Misure utili includono attività in sospeso con alta priorità, il tempo necessario per la conferma del contenimento e della risoluzione, la quota di asset con una valutazione corrente, problemi ricorrenti e eccezioni attive. Confrontare le misure con lo stesso ambito. La rimozione di un asset da un report o la modifica degli scanner può alterare i numeri senza ridurre il rischio reale.
Se le priorità sono concordate, ma le risorse tecniche non sono sufficienti per implementare e verificare le correzioni, discutere il lavoro con i responsabili della sicurezza tramite la pagina Remediazione delle vulnerabilità di sicurezza. Fornire risultati verificati, proprietari di sistemi e vincoli di modifica.