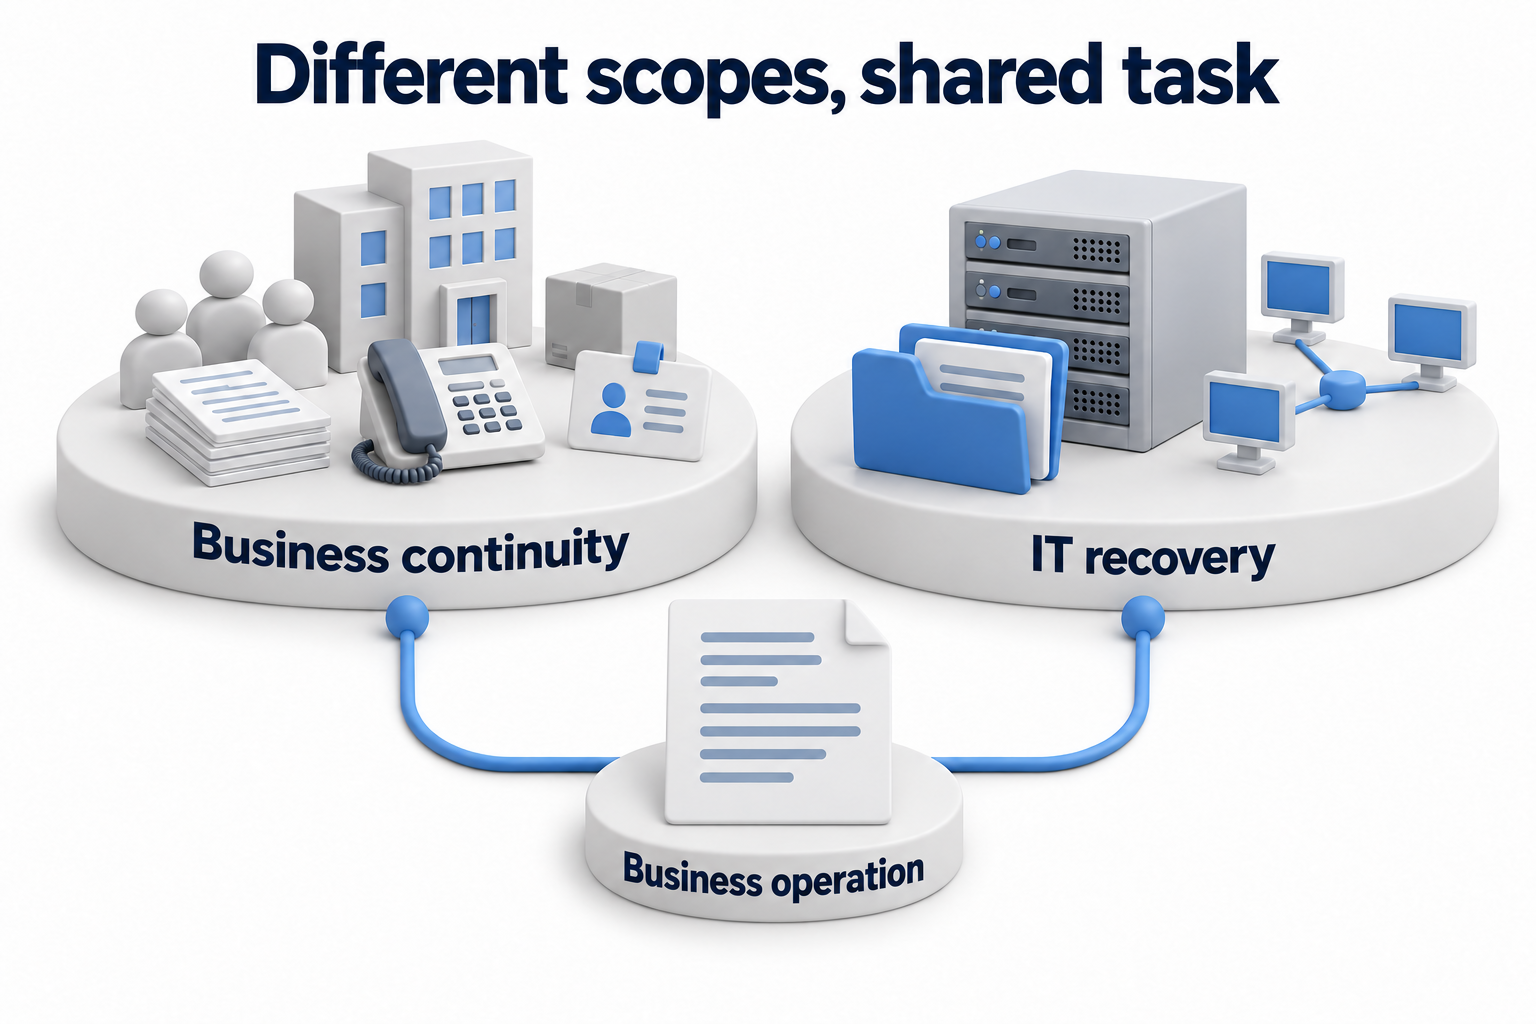
La continuità operativa riguarda il mantenimento delle attività importanti quando vengono meno le condizioni normali. Il ripristino di emergenza IT riguarda invece il recupero dei sistemi, dei dati e delle dipendenze tecniche necessari. Le due attività sono collegate, ma hanno ambiti diversi. Un server funzionante non aiuta a spedire un ordine se il personale o un fornitore non sono disponibili. Accettare ordini con una procedura temporanea non elimina la necessità di ripristinare il sistema e riconciliare i dati.
La scelta tra BCP e DRP è quindi solitamente una questione di titoli di documenti piuttosto che di responsabilità per il risultato. È possibile documentare un piano di continuità e un piano di recupero separatamente o come un unico insieme. Ciò che conta è l’accordo su priorità, responsabili e passaggio di decisioni.
Che cosa comprende ciascuna attività
Il BCP mantiene i processi aziendali importanti
Un piano di continuità operativa considera persone, strutture, attrezzature, comunicazioni, fornitori e procedure operative. Definisce quali operazioni devono continuare, a quale capacità accettabile e attraverso quali metodi temporanei. Questi potrebbero includere un luogo di lavoro alternativo, un altro canale di comunicazione o un processo manuale concordato. Verificate che l’alternativa sia funzionale prima di averne bisogno.
La continuità non garantisce il funzionamento senza interruzioni o perdite. Alcune operazioni possono funzionare in modalità limitata, mentre altre potrebbero non supportare una. La direzione e il responsabile del processo devono comprendere i limiti, le risorse disponibili e le conseguenze di una soluzione temporanea.
Il DRP ripristina la capacità tecnica di lavorare
Un piano di disaster recovery IT descrive come ripristinare o passare le applicazioni, i dati, i componenti di rete e le dipendenze necessarie. Richiede una sequenza, l’accesso ai backup e alle chiavi, un ambiente disponibile, ruoli assegnati e la verifica del risultato. Un backup è una risorsa, non l’intero piano.
La ripresa tecnica deve essere allineata con l’attività aziendale. Ripristinare un sistema che non supporta il processo prioritario può comportare un consumo di risorse senza il beneficio desiderato. Al contrario, un processo critico potrebbe dipendere da un servizio di autenticazione, integrazione o partecipante esterno che potrebbe essere facilmente trascurato. Entrambi i team devono essere consapevoli di queste dipendenze.
Le linee guida di AWS considerano la ripresa IT come parte di una strategia di continuità aziendale più ampia. Le priorità e gli obiettivi di ripristino devono tenere conto dell’attività aziendale, del rischio e dei costi. La sola disponibilità tecnica non affronta le conseguenze al di fuori dell’applicazione.
Confrontare ambito, responsabili e criteri di prontezza
Ambiti diversi all’interno di un unico intervento coordinato
|
Criterio |
Continuità operativa |
Ripristino di emergenza IT |
|---|---|---|
|
Domanda principale |
Come mantenere un’operazione importante quando le condizioni normali non sono più possibili |
Come ripristinare le risorse tecniche necessarie all’operazione |
|
Ambito |
Persone, strutture, fornitori, comunicazioni, procedure e dipendenze del sistema IT |
Applicazioni, dati, infrastruttura, accesso e dipendenze tecniche |
|
Responsabilità |
Responsabili e proprietari dei processi che collaborano con i dipartimenti competenti. |
Team tecnici che collaborano con i responsabili dei risultati aziendali |
|
Soluzione temporanea |
Una modalità operativa limitata o un processo alternativo concordato |
Ripristino, commutazione o qualsiasi altra procedura tecnica pianificata. |
|
Condizioni iniziali |
Priorità, impatto accettabile, risorse e vincoli |
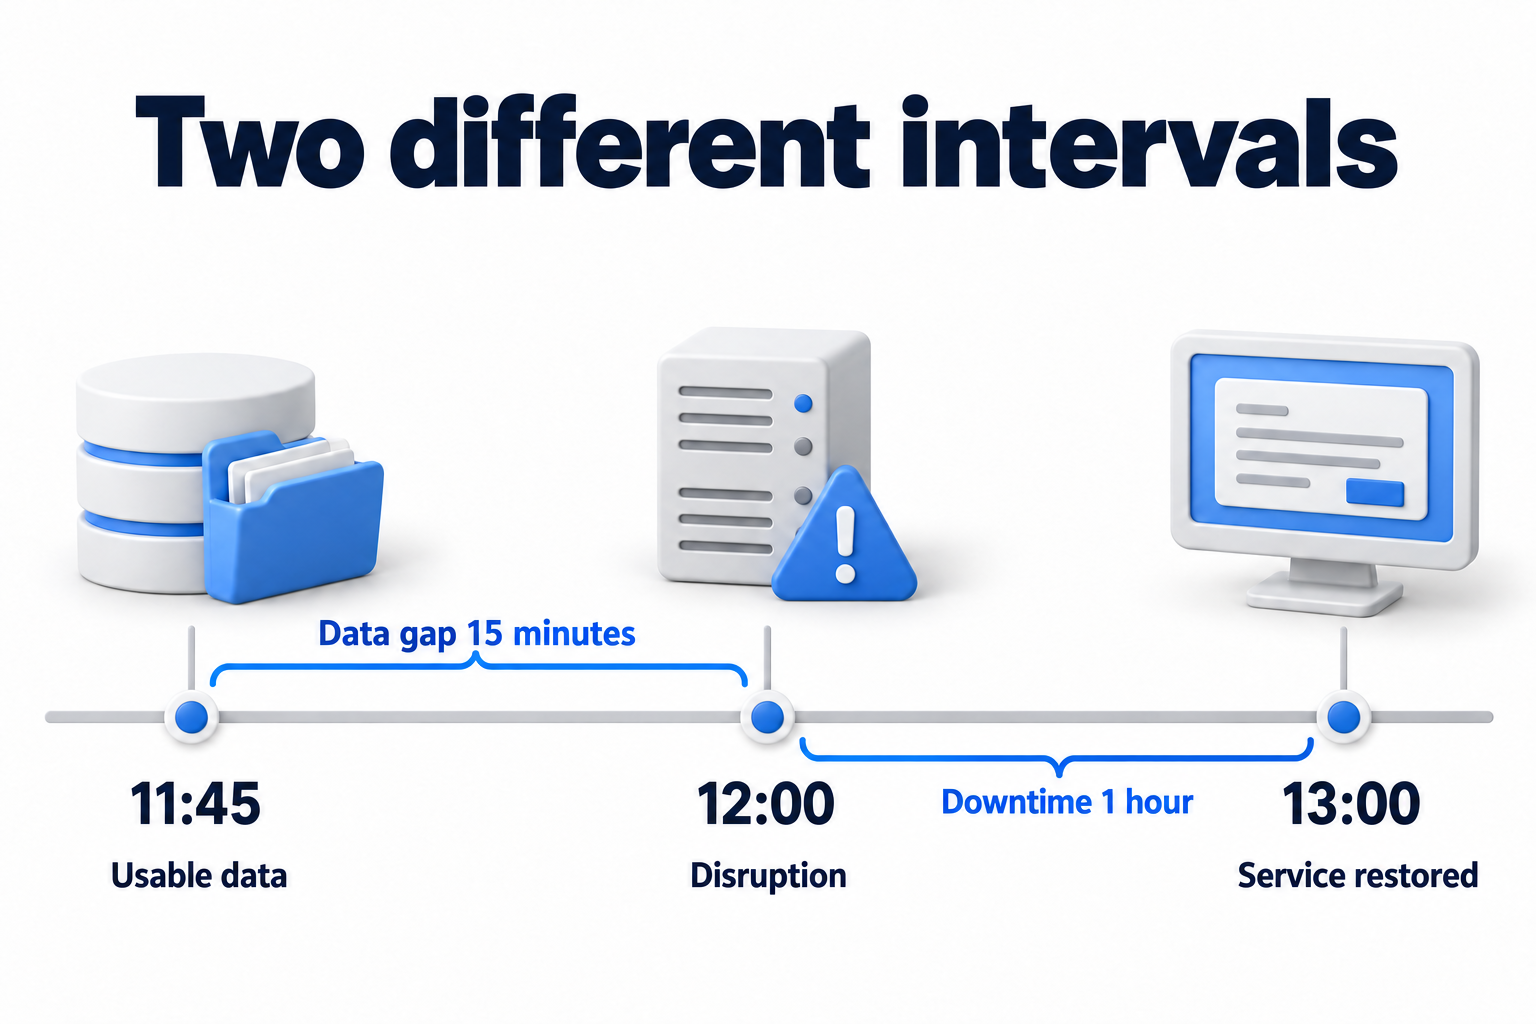
Requisiti di processo, accordi RPO (Recovery Point Objective) e RTO (Recovery Time Objective), e un ambiente e una procedura disponibili. |
|
Conferma del risultato |
L’operazione importante viene eseguita nella modalità concordata |
Il risultato tecnico e l’operazione aziendale superano la verifica |
|
Aggiornamenti |
Cambiano processi, persone, sedi o fornitori |
Cambiano sistemi, dati, dipendenze o percorso di ripristino |
Preparare entrambe le aree prima di un’interruzione. Durante un’interruzione, il lavoro può proseguire in parallelo: l’azienda organizza un funzionamento temporaneo accettabile mentre l’IT ripristina la sua infrastruttura tecnica. Non presumere che il piano di continuità operativa (BCP) si applichi solo prima di un disastro o che il disaster recovery inizi solo dopo che la crisi è completamente terminata. Definire le condizioni di attivazione e coordinamento nei piani.
Dove si colloca la risposta agli incidenti informatici
Un piano di risposta agli incidenti informatici aiuta a rilevare e valutare un evento, a limitarne le conseguenze e a concordare ulteriori azioni. Si collega al ripristino e alla continuità, ma non le sostituisce. Ad esempio, prima di ripristinare un’applicazione, stabilire se l’ambiente e i dati selezionati sono sicuri da utilizzare. Avviare la tecnologia senza tale accordo potrebbe riportare il problema.
Un guasto dell’apparecchiatura senza segni di un attacco può richiedere procedure diverse. Non considerare un piano di risposta informatica come il documento principale universale per ogni interruzione aziendale. La terza revisione delle linee guida NIST collega la risposta alla gestione più ampia del rischio informatico, che include la preparazione, il rilevamento, la risposta e il ripristino.
Collegare i piani tramite un’attività aziendale comune
Concordare priorità e modalità operativa accettabile
Utilizzare i risultati dell’analisi dell’impatto sul business: quali operazioni sono critiche, quali processi sono influenzati da un’interruzione e come cambiano le conseguenze nel tempo. Questi risultati supportano il confronto e la coordinazione dei piani. Un’analisi completa del rischio e il calcolo dell’impatto richiedono un lavoro separato. In questo caso, verificare che entrambi i team utilizzino le stesse priorità.
Per ogni processo importante, identificare il suo responsabile, le dipendenze tecniche e il modo di lavorare temporaneo accettabile. Gli obiettivi di RTO (Recovery Time Objective) e RPO (Recovery Point Objective) devono essere allineati con queste condizioni e con la fattibilità tecnica. Questo articolo non prescrive limiti di tempo universali né sostituisce una decisione separata sugli obiettivi.
Registrare chi attiva ogni insieme di azioni, chi approva le modifiche alle priorità e chi riceve la conferma di prontezza. Includere i partecipanti di backup, i team esterni e un canale di comunicazione da utilizzare quando gli strumenti normali non funzionano. Se i contatti sono disponibili solo all’interno del sistema inattivo, la coordinazione potrebbe interrompersi insieme ad esso.
Analizzare un’interruzione ipotetica
Supponiamo che il sito principale sia inattivo e che i dipendenti non possano utilizzare il sistema di elaborazione degli ordini. Lo scenario ipotetico seguente verifica i limiti di responsabilità. Non si tratta di una procedura standard per la vostra azienda. Verificare la fattibilità dell’acquisizione temporanea degli ordini e del metodo di recupero per il vostro ambiente.
Scenario ipotetico coordinato per l’inattivo del sito
|
Fase |
Azioni per la continuità |
Azioni per il ripristino IT |
Punto di coordinamento |
|---|---|---|---|
|
Valutazione dell’impatto |
Il responsabile del processo identifica le operazioni interessate e la capacità di lavoro accettabile |
Il team identifica i componenti inattivi e le dipendenze necessarie |
La direzione conferma le priorità e l’attivazione delle azioni pianificate. |
|
Operazioni temporanee |
Il team utilizza un canale approvato e registra le richieste in arrivo. |
L’IT prepara l’ambiente concordato e recupera dati utilizzabili |
I partecipanti sono a conoscenza dei limiti, dei responsabili e del prossimo aggiornamento dello stato. |
|
Ripristino tecnico |
Il responsabile prepara una prova dell’operazione aziendale richiesta |
L’IT ripristina il sistema e verifica dati, accessi e connessioni |
L’approvazione dipende dalla funzione, piuttosto che solo dall’avvio di un server. |
|
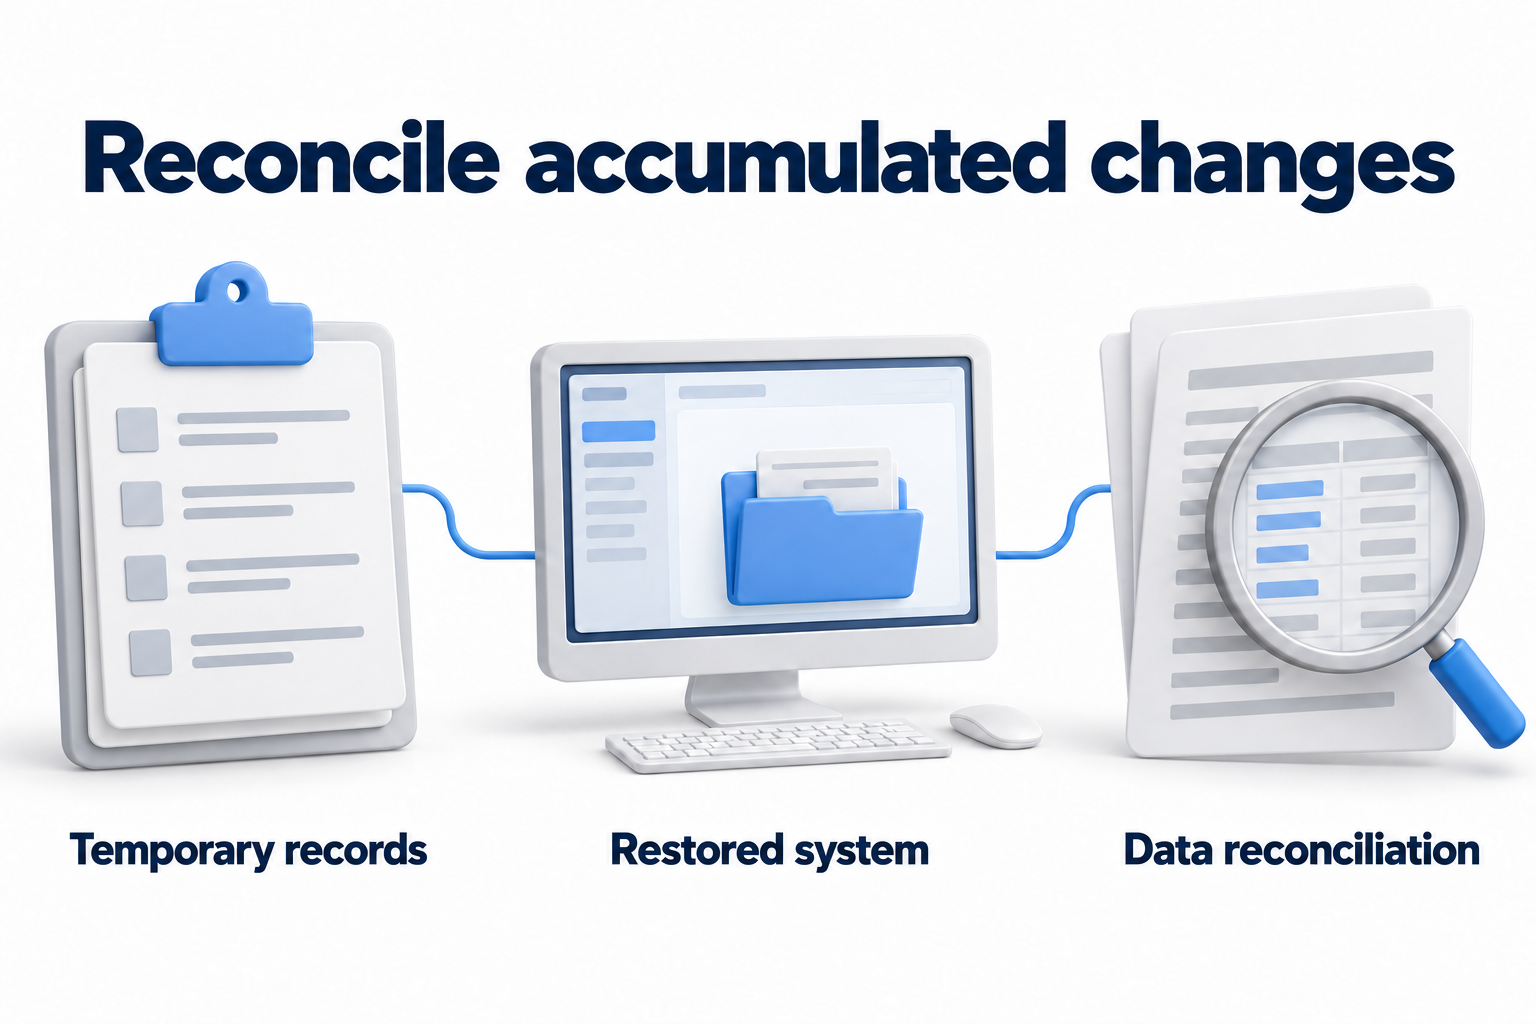
Riconciliazione delle registrazioni accumulate |
I responsabili assegnati confrontano le richieste e le modifiche provenienti dal periodo temporaneo. |
L’IT aiuta ad applicare il processo concordato di trasferimento e verifica |
Non si perdono dati, non compaiono duplicati, e i dati contestati vengono restituiti al proprietario. |
|
Ritorno alle normali operazioni |
Il proprietario conferma la fine delle operazioni temporanee e informa i partecipanti. |
Il team completa la transizione concordata e verifica la normale protezione. |
Vengono confermati il risultato aziendale, i limiti rimanenti e le ulteriori azioni. |
Se lo stesso scenario include segni di un attacco, coordinarsi anche con i responsabili della risposta alla sicurezza informatica. Non ripristinare la fiducia in un sistema semplicemente perché si avvia. Se il lavoro manuale temporaneo è inaccettabile, annotarlo anche. In tal caso, non si può garantire che sia un sostituto universale per l’IT.
Verificare le lacune nei passaggi di responsabilità
- L’azienda si aspetta che l’operazione sia disponibile, ma la verifica tecnica si limita all’avvio dell’infrastruttura.
- Esiste un modo di lavorare temporaneo, ma permessi, limiti e un proprietario rimangono non definiti.
- Le priorità del processo e la sequenza di ripristino del sistema non coincidono.
- È stato trascurato un servizio esterno, un fornitore, un canale di comunicazione o un partecipante di backup.
- Nessuno è responsabile della riconciliazione dei nuovi dati temporanei con il sistema ripristinato.
- Il team non sa chi approva il risultato e autorizza il ripristino.
- Contatti, istruzioni e prove esistono solo nell’ambiente non disponibile.
L’infrastruttura cloud, la ridondanza e l’automazione possono supportare il ripristino, ma non risolvono ogni problema che coinvolge persone, forniture e decisioni aziendali. Scegli le risorse per lo scenario concordato. L’acquisto di un prodotto etichettato “BCDR” non stabilisce i confini di responsabilità o i criteri di accettazione aziendale.
Provare il coordinamento e aggiornare le decisioni
Avvia una revisione congiunta con un’operazione selezionata: chi decide, come funziona il lavoro temporaneo, cosa viene ripristinato dall’IT e chi conferma il completamento. Lavorare sullo scenario aiuta a evidenziare i punti poco chiari. Testare il ripristino effettivo separatamente all’interno dello scope concordato. Una semplice discussione al tavolo non dimostra la prontezza tecnica.
Dopo la revisione, conservare le lacune identificate, i responsabili della risoluzione e le condizioni per il ri-test. Rivedere la connessione tra i piani dopo un cambiamento nel processo, nel team, nel sistema, nel fornitore o nel sito. La frequenza dipende dal rischio e dai requisiti applicabili, non da una affermazione generale secondo cui una revisione annuale è sufficiente per ogni attività.
Come passo successivo, creare una breve mappa di un’operazione: proprietario, modalità operativa accettabile, dipendenze IT, obiettivi, dati temporanei, accettazione e ripristino. Questo mostra cosa richiede l’accordo. Sviluppare modelli completi per BCP e DRP, istruzioni di ripristino e registri di esercitazione per le condizioni specifiche.
È necessario verificare se la soluzione di ripristino IT è in linea con le priorità aziendali? Contattare DKs Enterprises per informazioni su backup e disaster recovery. Preparare un elenco delle operazioni più importanti, delle dipendenze tecniche e delle lacune note per discutere l’ambito del lavoro.