Una prova di ripristino di emergenza risponde a una domanda pratica: il team riesce a ripristinare l’operazione aziendale richiesta nelle condizioni concordate? Un backup, un documento o una sede di ripristino non sono ancora una risposta. Il team deve eseguire il percorso di ripristino scelto, verificare dati e dipendenze, misurare il risultato e colmare le lacune rilevate.
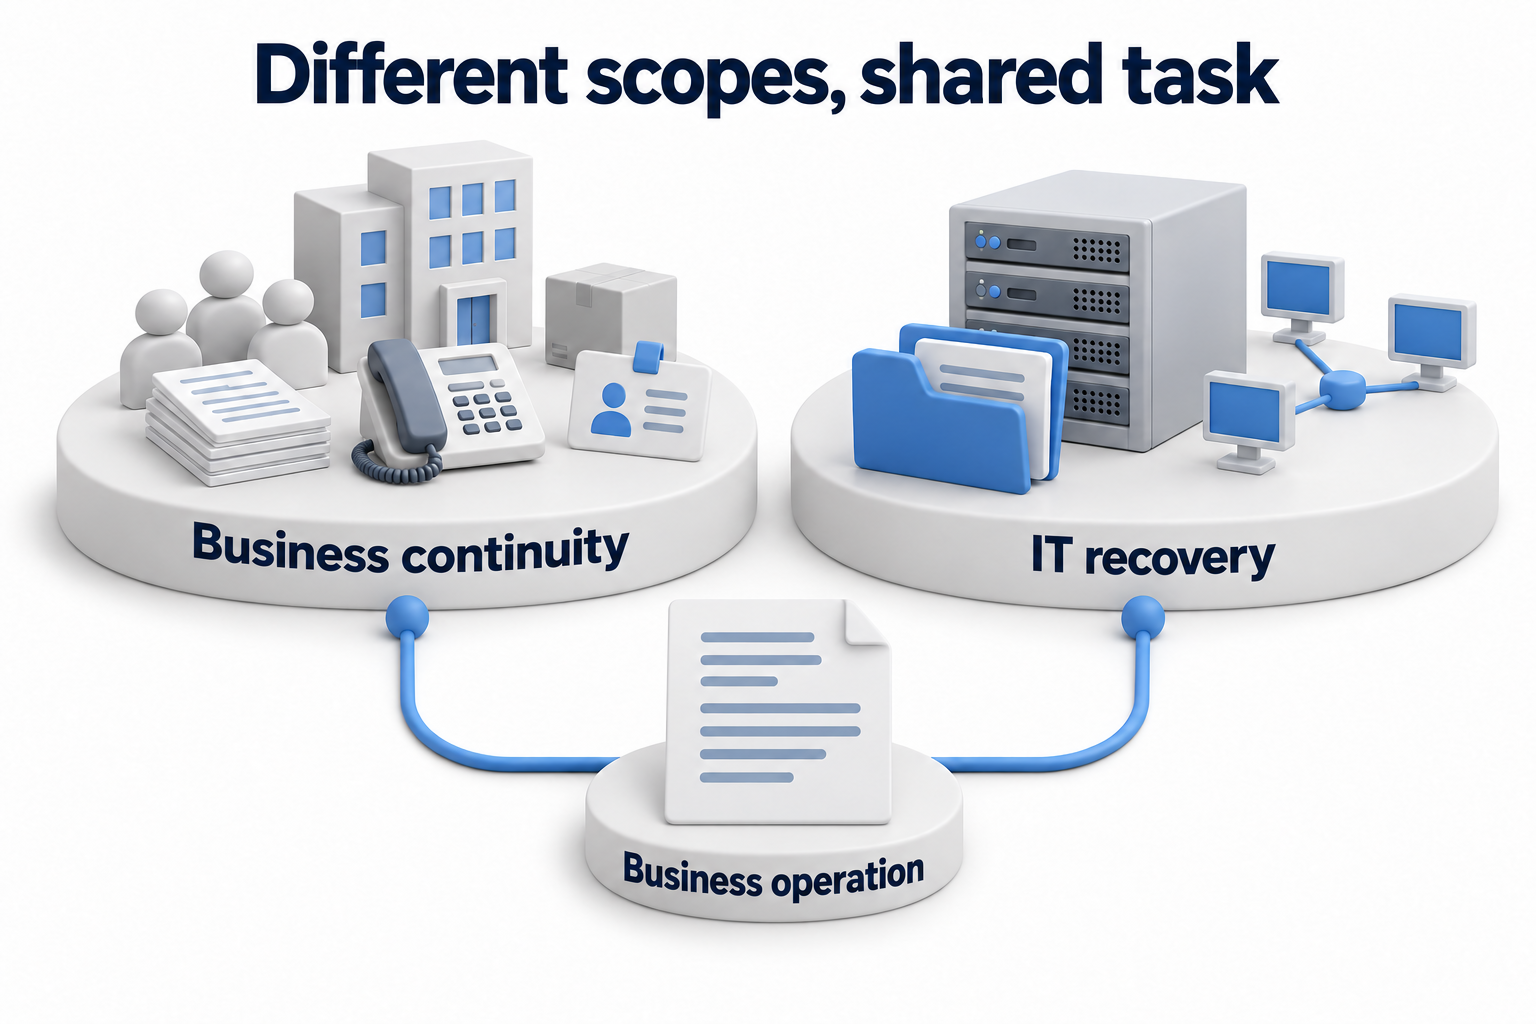
Il documento di partenza è il piano di ripristino attuale. I test non sostituiscono la sua elaborazione, né la valutazione dei rischi specifici di ogni azienda, né la pianificazione della continuità operativa. Se il sistema, il proprietario, la priorità o il criterio di prontezza sono sconosciuti, chiarire prima tali informazioni. In caso contrario, un avvio di server di successo può facilmente essere interpretato come il ripristino dell’intero processo.
Definire la domanda a cui deve rispondere l’esercitazione
Selezionare una singola ipotesi chiara. Ad esempio: è possibile ripristinare l’elaborazione degli ordini se lo spazio di archiviazione principale non è disponibile? Indicare quale parte dell’ambiente è considerata persa e quali strumenti normali non possono essere utilizzati. Non lasciare che il team si affidi silenziosamente al componente che si intende testare.
Utilizzare gli obiettivi concordati di RPO (Recovery Point Objective) e RTO (Recovery Time Objective) come input. Registrare l’età accettabile di un punto di ripristino utilizzabile e il tempo massimo per ripristinare l’operazione. Chiarire quale evento avvia il conteggio e cosa si considera come completamento. Copia dei file, avvio di una macchina virtuale e conferma di una misura operativa aziendale rappresentano fasi diverse.
Definire il risultato minimo con il responsabile del processo. Per un’applicazione, ciò potrebbe includere l’accesso di un utente, l’accesso ai dati necessari e il completamento di un’operazione concordata. Il test deve coprire le dipendenze necessarie: autenticazione, rete, permessi, database, integrazioni e servizi esterni. L’insieme specifico dipende dal sistema.
Scegliere il tipo di prova e i limiti delle sue conclusioni
La validità della conclusione dipende dalle azioni effettivamente eseguite.
|
Tipo |
Che cosa verifica |
Che cosa non si può ancora concludere |
|---|---|---|
|
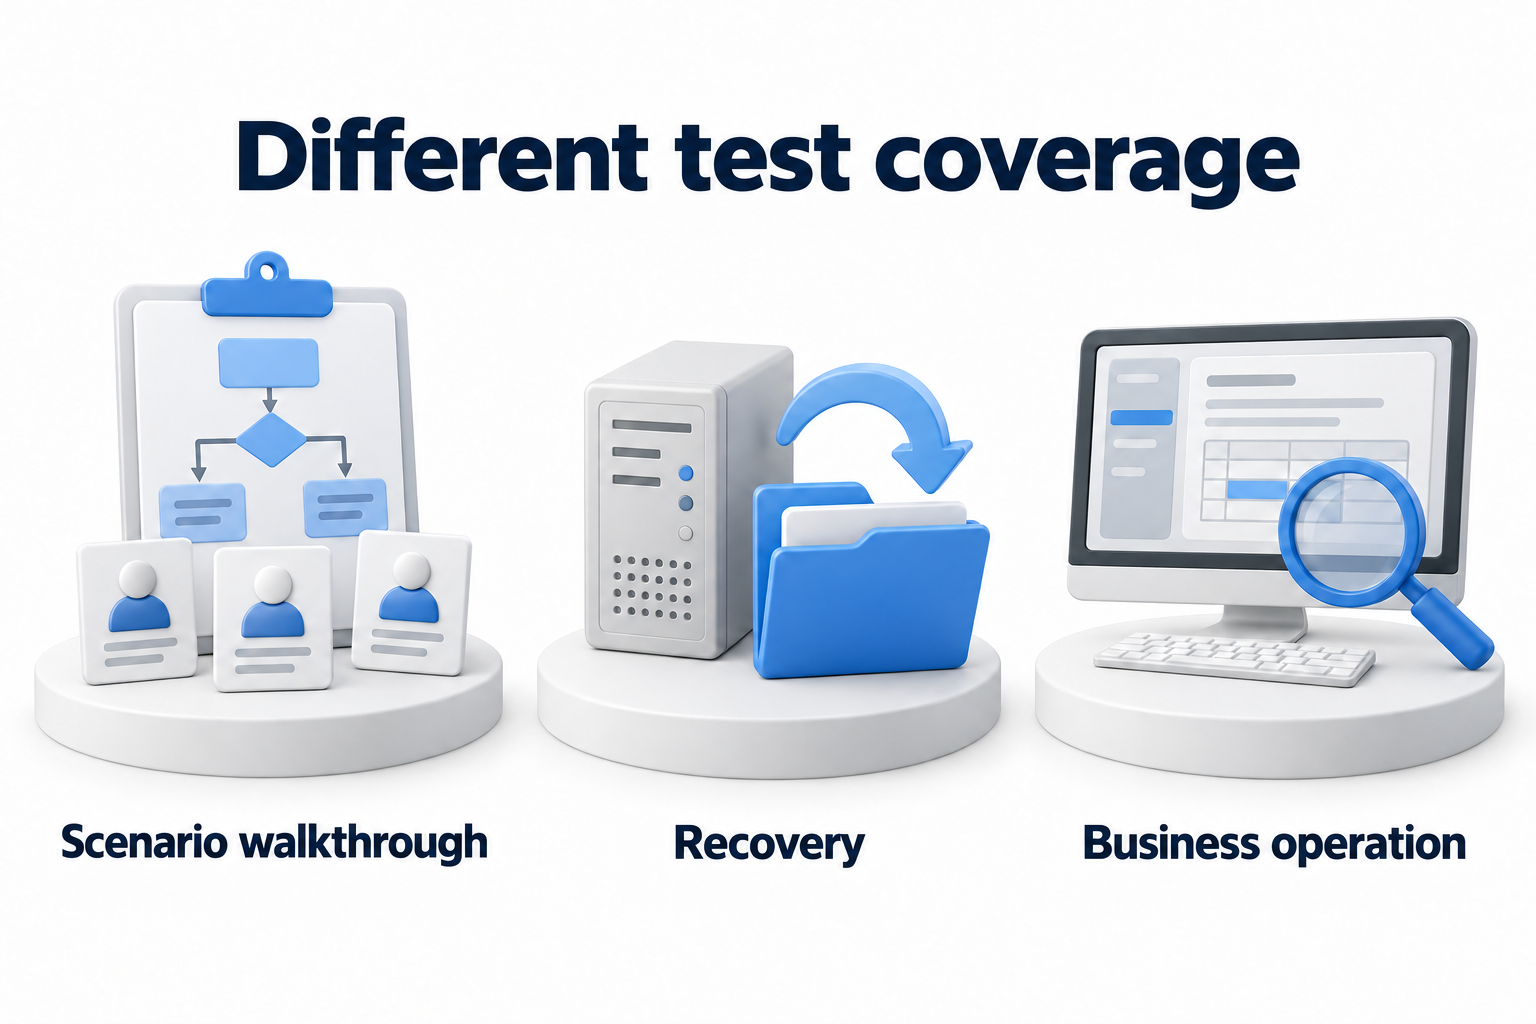
Analisi dello scenario con i partecipanti |
Decisioni, ruoli, sequenza e disponibilità delle istruzioni |
Che i dati siano stati effettivamente ripristinati entro il tempo richiesto |
|
Ripristino di un singolo componente |
Recupero e utilizzo del backup selezionato, e avvio dei componenti |
Che l’intero processo collegato sia pronto per il lavoro |
|
Ripristino di un servizio connesso in un ambiente di prova |
Dipendenze e operazione aziendale entro l’ambito definito |
Che siano stati riprodotti il carico di produzione e tutti i vincoli reali |
|
Passaggio a un ambiente di ripristino |
Il percorso di passaggio concordato, l’accesso e l’esecuzione delle operazioni |
Che siano stati provati anche il ritorno e la riconciliazione dei nuovi dati |
|
Esercitazione completa |
Coordinamento del team e più percorsi collegati |
Che sia stata verificata ogni possibile emergenza |
Iniziare a un livello adatto al team. Un esercizio di simulazione aiuta a identificare aree di incertezza e contatti non disponibili. Non sostituisce il recupero tecnico. In un esercizio più complesso, distinguere tra azioni discusse e azioni effettivamente eseguite. Il rapporto deve evidenziare questi risultati in modo chiaro.
Preparare condizioni sicure e partecipanti
Concordare operazioni, arresto e procedure di ritorno
Nominare un responsabile dei test, gli implementatori, un osservatore, il responsabile dell’accettazione operativa e una persona autorizzata a interrompere l’esercizio. Nominare sostituti e collaboratori se necessario. Verificare i loro accessi e la loro disponibilità in anticipo. Concordare un orario di lavoro e informare coloro che potrebbero essere interessati.
Registrare le condizioni di interruzione immediata, l’impatto accettabile e la procedura di ripristino. Verificare che il team possa ripristinare uno stato sicuro se il test stesso fallisce. Non spegnere i sistemi di produzione semplicemente per realismo, senza un’autorizzazione e una preparazione separate. Se necessario, esercitare azioni pericolose in un ambiente limitato.
Identificare dove interagiscono l’ambiente di test e l’ambiente di produzione. Isolare le connessioni e le azioni esterne non necessarie che potrebbero inviare e-mail, pagamenti o comandi di integrazione reali. Utilizzare i dati in conformità con la politica di accesso corrente. I segreti di produzione e i dati sensibili non devono essere inclusi in un rapporto di test accessibile pubblicamente.
Verificare risorse e percorsi di accesso
- Identificare le versioni delle istruzioni, la configurazione del sistema e una mappa delle dipendenze necessarie.
- Confermare un punto di ripristino adeguato e come recuperarlo.
- Verificare le chiavi, il catalogo, il software di ripristino e le autorizzazioni necessarie.
- Chiarire la capacità dell’ambiente di ripristino, lo spazio disponibile, i limiti e i limiti di rete.
- Garantire l’accesso alle istruzioni e ai contatti quando il sito principale non è disponibile.
- Stabilire un canale di comunicazione di backup e definire come contattare i partecipanti esterni.
- Preparare un registro di tempi, evidenze, decisioni e scostamenti.
AWS evidenzia in particolare le modifiche alla configurazione dell’ambiente di ripristino, alle quote e alla capacità. Le funzionalità sufficienti per il test precedente potrebbero non essere più adeguate dopo la crescita del carico di lavoro. Pertanto, un nuovo test utilizza l’ambiente corrente e le differenze note, piuttosto che solo un vecchio rapporto di successo.
Eseguire lo scenario e distinguere i fatti dalle ipotesi
Prima di iniziare, registrare lo stato iniziale, il backup selezionato, i partecipanti e i limiti. Dare il segnale di inizio concordato. Seguire la procedura in ordine, registrando l’inizio e la fine delle fasi significative. Se le istruzioni sono incomplete, registrare la decisione manuale necessaria e chi l’ha approvata. Non riscrivere la cronologia delle azioni in seguito.
Registrare le deviazioni dallo scenario. Ad esempio, il team potrebbe ottenere una chiave attraverso un canale di lavoro normale che doveva essere inaccessibile. Questa azione potrebbe aiutare a completare l’esercizio, ma non conferma l’ipotesi originale. Mantenere la limitazione e assegnare un test separato del percorso non provato.
Dopo l’avvio tecnico, il responsabile del processo esegue la verifica di accettazione concordata. Verificare la completezza e la validità dei dati, le autorizzazioni richieste, le integrazioni e le operazioni aziendali. Se si sta testando il carico, specificare il suo volume e le condizioni. Un piccolo test non giustifica l’affermazione di prontezza per qualsiasi carico di produzione.
Misurare il risultato effettivo rispetto agli obiettivi
Per valutare la perdita di dati, confrontare il tempo simulato di interruzione con l’ultimo punto di ripristino effettivamente ripristinato. Ciò che conta è il punto di successo utilizzato, non il tempo dell’ultima operazione contrassegnata come tale. Se i dati sono corrotti, trovare uno stato precedente utilizzabile e registrare la nuova lacuna.
Utilizzare l’inizio e la fine concordate per misurare la durata. Mantenere anche le fasi intermedie: rilevamento, decisione di ripristino, preparazione dell’ambiente, recupero dei dati, avvio e accettazione operativa. Ciò mostra dove si è verificato il ritardo. Non definire il tempo di RTO target come il tempo effettivo o escludere una fase scomoda senza spiegazione.
Valutare il risultato rispetto all’insieme completo di criteri. Raggiungere l’obiettivo di tempo non è sufficiente se la verifica dei dati fallisce o una funzione importante non è disponibile. Se alcune condizioni sono state simulate, specificare quali conclusioni la reale esecuzione conferma e quali rimangono ipotesi.
Verificare il completamento e il ritorno
Per uno scenario di failover, decidete in anticipo se provare anche il ritorno all’ambiente principale. I nuovi dati creati nell’ambiente di ripristino richiedono una procedura concordata di trasferimento e riconciliazione. Non riavviate semplicemente la vecchia istanza di produzione senza risolvere le discrepanze. Il ritorno viene confermato da un responsabile autorizzato, non soltanto dall’amministratore dell’infrastruttura.
Dopo l’esercizio, disconnetti le connessioni di test non necessarie, rimuovi o conserva i dati di test in conformità con la politica concordata e ripristina le autorizzazioni temporanee al loro stato normale. Verifica che il backup e il monitoraggio siano ripresi ovunque siano state apportate modifiche temporanee. Anche la conclusione del test richiede una conferma.
Preparare un rapporto con evidenze verificabili
Copia il modulo e compilalo con i risultati effettivi. Se uno scenario testa diversi sistemi, utilizza righe di risultati separate o allegati chiaramente collegati. Non sostituire un valore sconosciuto con “successo”. I campi con verifica incompleta necessitano di un proprietario per l’azione successiva.
Rapporto della prova di ripristino di emergenza
|
Campo del rapporto |
Che cosa registrare |
|---|---|
|
Scenario e confini |
[Componenti guasti, strumenti non disponibili, operazione da verificare] |
|
Configurazione e versione |
[Sistema, dipendenze, istruzioni, data e partecipanti] |
|
Obiettivi e accettazione |
[RPO, RTO, inizio del conteggio e criteri di prontezza concordati] |
|
Tipo e sicurezza |
[Azioni eseguite, simulazioni, autorizzazioni, arresto e ripristino] |
|
Punto di ripristino |
[Identificativo e riferimento temporale dei dati ripristinati utilizzabili] |
|
Cronologia |
[Fase iniziale, fasi significative e conferma della prontezza operativa] |
|
Previsto ed effettivo |
[Valori obiettivo ed effettivi, esito della prova operativa] |
|
Evidenze |
[Log, esiti delle prove e collegamenti protetti] |
|
Limiti |
[Simulazioni, differenze dell’ambiente, dipendenze non verificate] |
|
Scostamenti e correzioni |
[Errore, impatto, responsabile, scadenza e nuova prova richiesta] |
|
Completamento |
[Ritorno, riconciliazione dei dati, rimozione dell’accesso temporaneo e conferma] |
|
Accettazione |
[Responsabile tecnico, responsabile del processo e decisione sul risultato] |
Risolvere gli errori e programmare la prova successiva
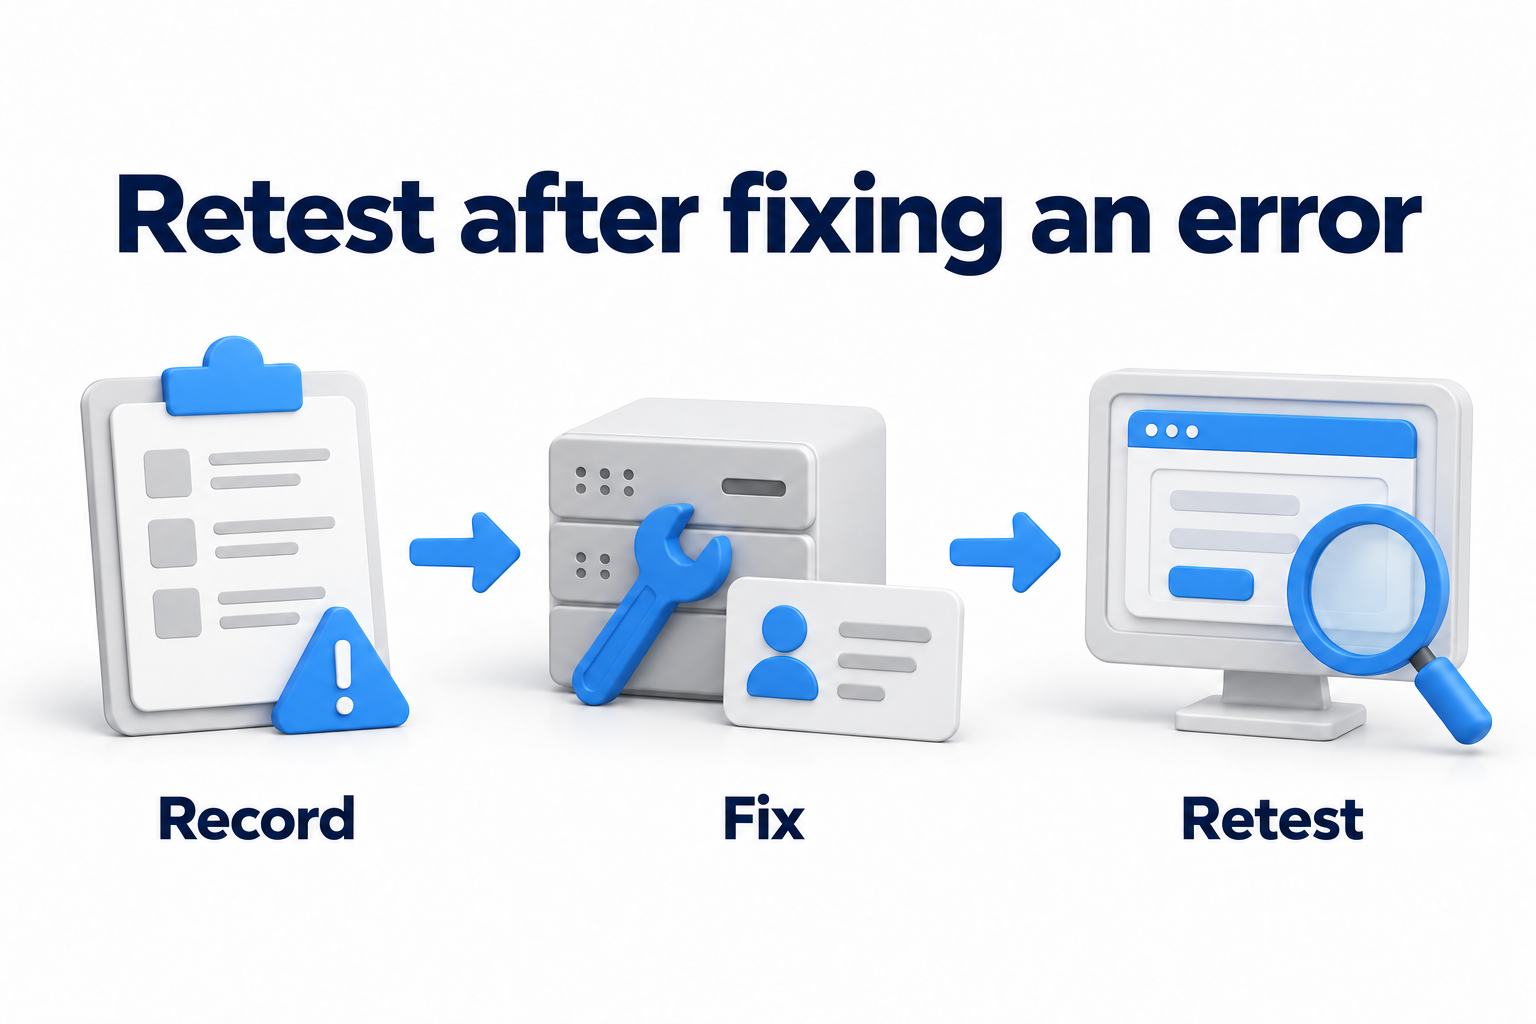
Verificare i risultati con i partecipanti. Distinguere le carenze di risorse dai problemi relativi alle istruzioni, all’accesso e alla coordinazione. Assegnare un responsabile, una scadenza e criteri chiari per la risoluzione di ogni deviazione significativa. Aggiornare le procedure, i contatti e la configurazione, quindi riprovare il percorso modificato. Una nota che dice “tenuto in considerazione” non chiude un errore senza prove.
Dimostrare la prontezza della gestione all’interno dell’ambito testato: quali operazioni sono confermate, dove sono mancati gli obiettivi e cosa rimane non testato. L’automazione può raccogliere i tempi, eseguire passaggi ripetibili e conservare un registro. Anche i suoi scenari, le sue autorizzazioni e i suoi risultati devono essere verificati; non garantiscono automaticamente il successo.
La criticità, le modifiche, gli errori passati e i requisiti applicabili determinano la frequenza. Inoltre, è necessario pianificare test dopo modifiche significative al sistema, al sito, ai dati, al team o al fornitore. Una regola universale secondo cui una volta all’anno è sufficiente per tutti ignora queste differenze. Verificare se le dipendenze cambiano tra gli esercizi programmati.
Avete bisogno di effettuare un test di ripristino o di eseguire una simulazione? Contattate DKs Enterprises per soluzioni di backup e ripristino in caso di emergenza. Fornite lo scenario, i criteri concordati e i risultati precedenti per discutere l’ambito del lavoro.