Una prueba de recuperación ante desastres responde a una pregunta práctica: ¿puede el equipo restaurar la operación empresarial requerida bajo las condiciones acordadas? Una copia de seguridad, un documento o un sitio de recuperación no lo hacen. El equipo debe ejecutar la ruta de recuperación seleccionada, verificar los datos y las dependencias, medir el resultado y corregir las deficiencias encontradas.
El documento inicial aquí es el plan de recuperación actual. La prueba no sustituye a su desarrollo, a la evaluación de los riesgos de cada empresa o a la planificación de la continuidad del negocio. Si el sistema, el propietario, la prioridad o el criterio de preparación son desconocidos, primero debe aclararlos. De lo contrario, un inicio de servidor exitoso puede confundirse fácilmente con la recuperación de todo el proceso.
Defina la pregunta que debe responder el ejercicio
Elija una hipótesis clara. Por ejemplo: ¿se puede restaurar el procesamiento de pedidos si el almacenamiento primario no está disponible? Indique qué parte del entorno se considera perdida y qué herramientas normales no se pueden utilizar. No permita que el equipo confíe silenciosamente en el componente cuyo fallo se pretende probar.
Utilice los objetivos de RPO y RTO acordados como entradas. Registre la edad aceptable de un punto de recuperación utilizable y el tiempo máximo para restablecer la operación. Aclare qué evento inicia el contador y qué se considera como finalización. La copia de archivos, el inicio y la confirmación de una operación empresarial representan diferentes etapas.
Defina el resultado mínimo de trabajo con el responsable del proceso. Para una aplicación, esto puede incluir el inicio de sesión del usuario, el acceso a los datos requeridos y la finalización de una operación acordada. La prueba debe cubrir las dependencias necesarias: autenticación, la red, permisos, bases de datos, integraciones y servicios externos. El conjunto específico depende del sistema.
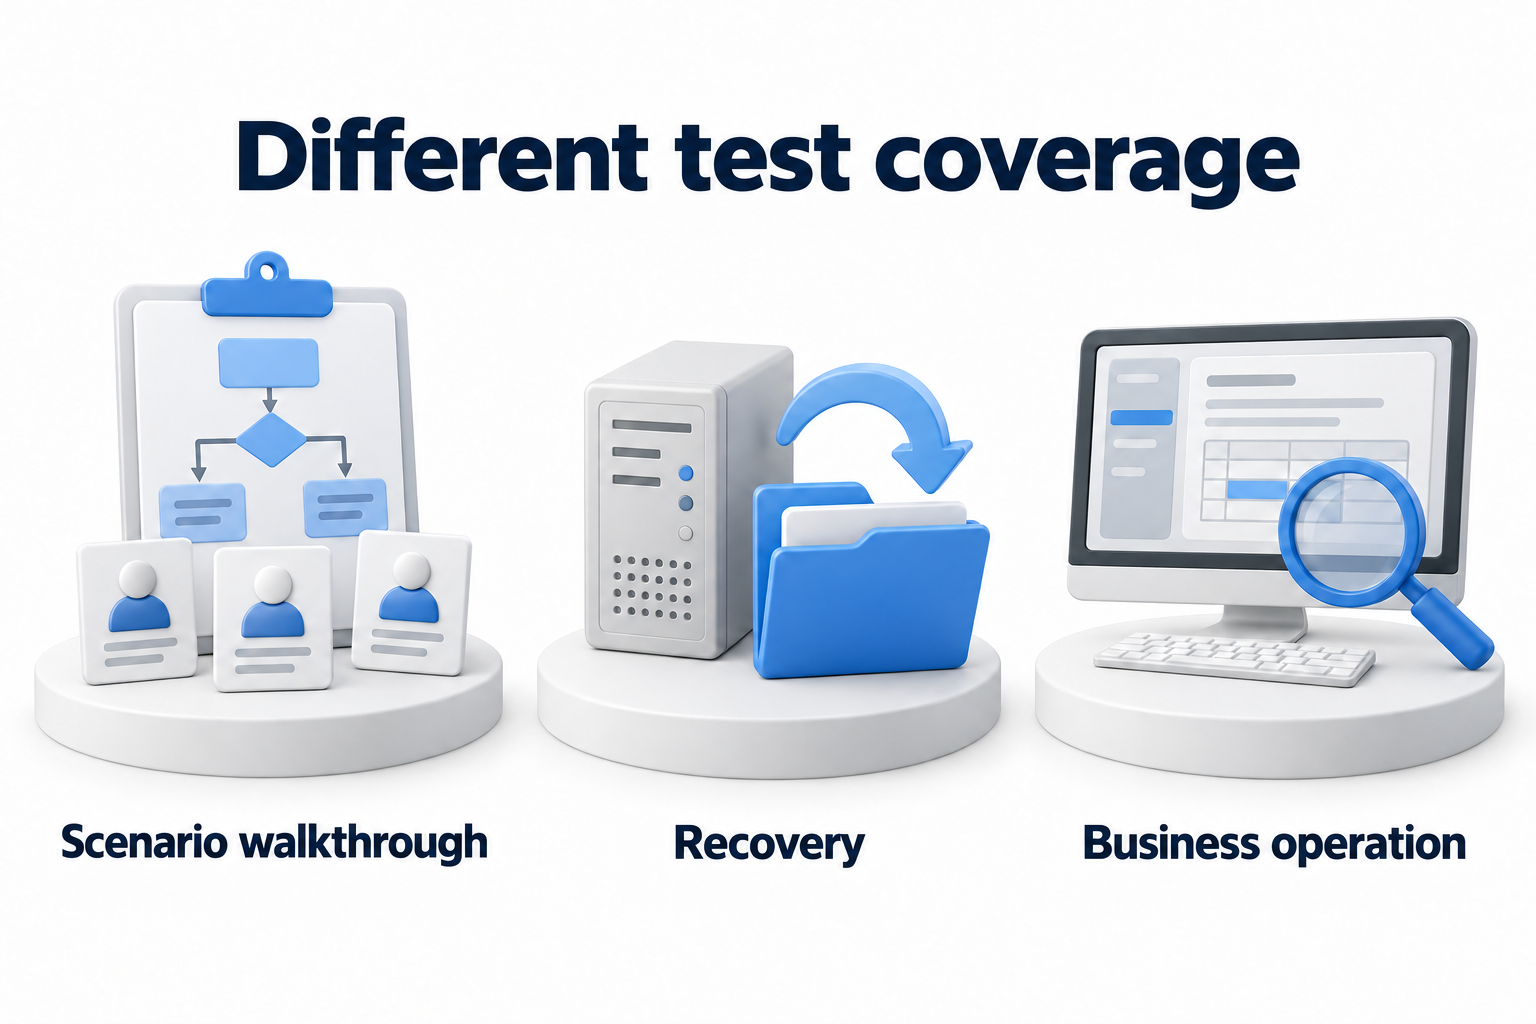
Elija el tipo de prueba y los límites de sus conclusiones
La validez de la conclusión depende de las acciones que realmente se hayan realizado
|
Tipo |
Qué verifica |
Qué aún no se puede concluir |
|---|---|---|
|
Realización de escenarios con los participantes |
Decisiones, roles, secuencia y disponibilidad de instrucciones |
Que los datos se hayan restaurado realmente dentro del tiempo requerido |
|
Recuperación de un único componente |
Obtención y utilizabilidad de la copia de seguridad seleccionada, y inicio del componente |
Que todo el proceso conectado esté listo para su funcionamiento. |
|
Recuperación de un servicio conectado en un entorno de prueba. |
Dependencias y la operación empresarial dentro del alcance definido. |
Que se hayan reproducido la carga de producción y todas las restricciones reales. |
|
Conmutación a un entorno de recuperación. |
La ruta de conmutación acordada, el acceso y la prestación de servicios a las operaciones. |
Que también se hayan probado la conmutación de vuelta al entorno principal y la conciliación de los nuevos datos |
|
Ejercicio exhaustivo. |
Coordinación del equipo y varias rutas conectadas. |
Que se hayan probado todas las posibles situaciones de desastre. |
Comenzar en un nivel en el que el equipo esté preparado. Una revisión de escenarios ayuda a identificar áreas de incertidumbre y contactos no disponibles. No sustituye a la recuperación técnica. En un ejercicio más complejo, distinguir entre las acciones que solo se discuten y las que realmente se realizan. El informe debe hacer que estos resultados sean distinguibles.
Prepare condiciones y participantes seguros
Acuerden las acciones, los procedimientos de parada y retorno
Designe un líder de prueba, implementadores, un observador, el responsable de la aceptación operativa y una persona autorizada para detener el ejercicio. Nombre sustitutos y contratistas si la recuperación lo requiere. Verifique su acceso y disponibilidad con antelación. Acuerde un horario de trabajo y notifique a quienes puedan verse afectados.
Registre las condiciones inmediatas de parada, el impacto aceptable y el procedimiento de retorno. Verifique que el equipo pueda restaurar un estado seguro si la prueba en sí falla. No apague los sistemas de producción simplemente por realismo sin autorización y preparación separadas. Practique acciones peligrosas en un entorno limitado si es necesario.
Identifique dónde interactúan los entornos de prueba y producción. Aísle las conexiones y acciones externas innecesarias que puedan enviar correos electrónicos, pagos o comandos de integración reales. Utilice datos bajo la política de acceso actual. Los secretos de producción y los datos sensibles no deben aparecer en un informe de prueba de acceso abierto.
Verifique los recursos y las vías de acceso
- Identifique las versiones de las instrucciones, la configuración del sistema y un mapa de las dependencias necesarias.
- Confirme un punto de recuperación adecuado y cómo recuperarlo.
- Verifique las claves, el catálogo, el software de recuperación y los permisos necesarios.
- Aclare la capacidad del entorno de recuperación, el espacio disponible, las cuotas y los límites de red.
- Asegúrese de tener acceso a las instrucciones y los contactos cuando el sitio principal no esté disponible.
- Acuerden un canal de comunicación de respaldo y cómo contactar a los participantes externos.
- Prepare un registro de horarios, evidencia, decisiones y desviaciones.
AWS destaca específicamente los cambios en la configuración del entorno de recuperación, las cuotas y la capacidad. Las capacidades que fueron suficientes para la prueba anterior pueden no ser suficientes después del crecimiento de la carga de trabajo. Por lo tanto, una prueba repetida utiliza el entorno actual y las diferencias conocidas, en lugar de solo un informe anterior exitoso.
Ejecute el escenario y separe los hechos de las suposiciones
Antes de comenzar, registre el estado inicial, la copia de seguridad seleccionada, los participantes y los límites. Proporcione la señal de inicio acordada. Siga el procedimiento en orden, registrando el inicio y el final de las etapas significativas. Si las instrucciones son incompletas, registre la decisión manual requerida y quién la aprobó. No reescriba el historial de acciones posteriormente.
Registre las desviaciones del escenario. Por ejemplo, el equipo puede obtener una clave a través de un canal de trabajo normal que supuestamente no estaba disponible. Esta acción puede ayudar a completar el ejercicio, pero no confirma la hipótesis original. Mantenga la limitación y asigne una prueba separada del camino no probado.
Después del inicio técnico, el propietario del proceso realiza la verificación de aceptación acordada. Confirme la integridad y la actualidad de los datos, los permisos requeridos, las integraciones y la operación comercial. Si se está realizando una prueba de carga, indique su volumen y condiciones. Una pequeña prueba no justifica afirmar la preparación para cualquier carga de producción.
Mida el resultado real frente a los objetivos
Para evaluar la pérdida de datos, compare el tiempo de interrupción simulado con el último punto utilizable que se ha restaurado realmente. Lo importante es el punto que se utilizó con éxito, no el tiempo del último trabajo marcado como exitoso. Si los datos están corruptos, encuentre un estado anterior utilizable y registre la nueva brecha.
Utilice el inicio y el final de medición acordados para evaluar la duración. También conserve las etapas intermedias: detección, la decisión de recuperación, preparación del entorno, recuperación de datos, inicio y aceptación operativa. Esto muestra dónde ocurrió el retraso. No llame al objetivo de RTO como el tiempo real o excluya una etapa inconveniente sin explicación.
Evalúe el resultado frente al conjunto completo de criterios. Cumplir el objetivo de tiempo no es suficiente si la verificación de datos falla o una función importante no está disponible. Si se simularon ciertas condiciones, indique qué conclusiones confirma la ejecución real y cuáles permanecen como suposiciones.
Verifique la finalización y devuelva
Para un escenario de conmutación al entorno de recuperación, decida de antemano si también probará el regreso al entorno principal. Los datos nuevos creados en el entorno de recuperación necesitan un procedimiento acordado de transferencia y conciliación. No ponga en marcha la antigua instancia de producción sin resolver las discrepancias. Una persona responsable autorizada confirma el regreso, no solo el administrador de infraestructura.
Después del ejercicio, desconecte las conexiones de prueba innecesarias, elimine o conserve los datos de prueba según la política acordada y restaure los permisos temporales a su estado normal. Verifique que la copia de seguridad y el monitoreo se han restablecido en cualquier lugar donde se hayan modificado temporalmente la configuración. La finalización de la prueba también requiere confirmación.
Prepare un informe con evidencia verificable
Copie el formulario y rellénelo con los resultados reales. Si un escenario prueba varios sistemas, utilice filas de resultados separadas o anexos claramente vinculados. No reemplace un valor desconocido con «éxito». Los campos con verificación incompleta necesitan un propietario para la siguiente acción.
Informe de prueba de recuperación ante desastres
|
Campo del informe |
Qué registrar |
|---|---|
|
Escenario y límites |
[Componentes fallidos, herramientas no disponibles, operación en prueba] |
|
Configuración y versión |
[Sistema, dependencias, instrucciones, fecha y participantes] |
|
Objetivos y aceptación |
[RPO, RTO acordados, hora de inicio y criterios de preparación] |
|
Tipo y seguridad |
[Acciones realizadas, simulaciones, autorización, parada y retorno] |
|
Punto de recuperación |
[Identificador y marca de tiempo de los datos restaurados utilizables] |
|
Cronología |
[Inicio, etapas significativas y confirmación de la preparación para el funcionamiento] |
|
Esperado y real |
[Valores objetivo y reales, resultado de la prueba de funcionamiento] |
|
Evidencia |
[Registros, resultados de pruebas y enlaces protegidos] |
|
Límites |
[Simulaciones, diferencias ambientales, dependencias no probadas] |
|
Desviaciones y soluciones |
[Error, impacto, responsable, fecha límite y re-prueba requerida] |
|
Finalización |
[Retorno, conciliación de datos, eliminación de acceso temporal y confirmación] |
|
Aceptación |
[Responsable técnico, responsable del proceso y decisión sobre el resultado] |
Cerrar errores y programar la siguiente prueba
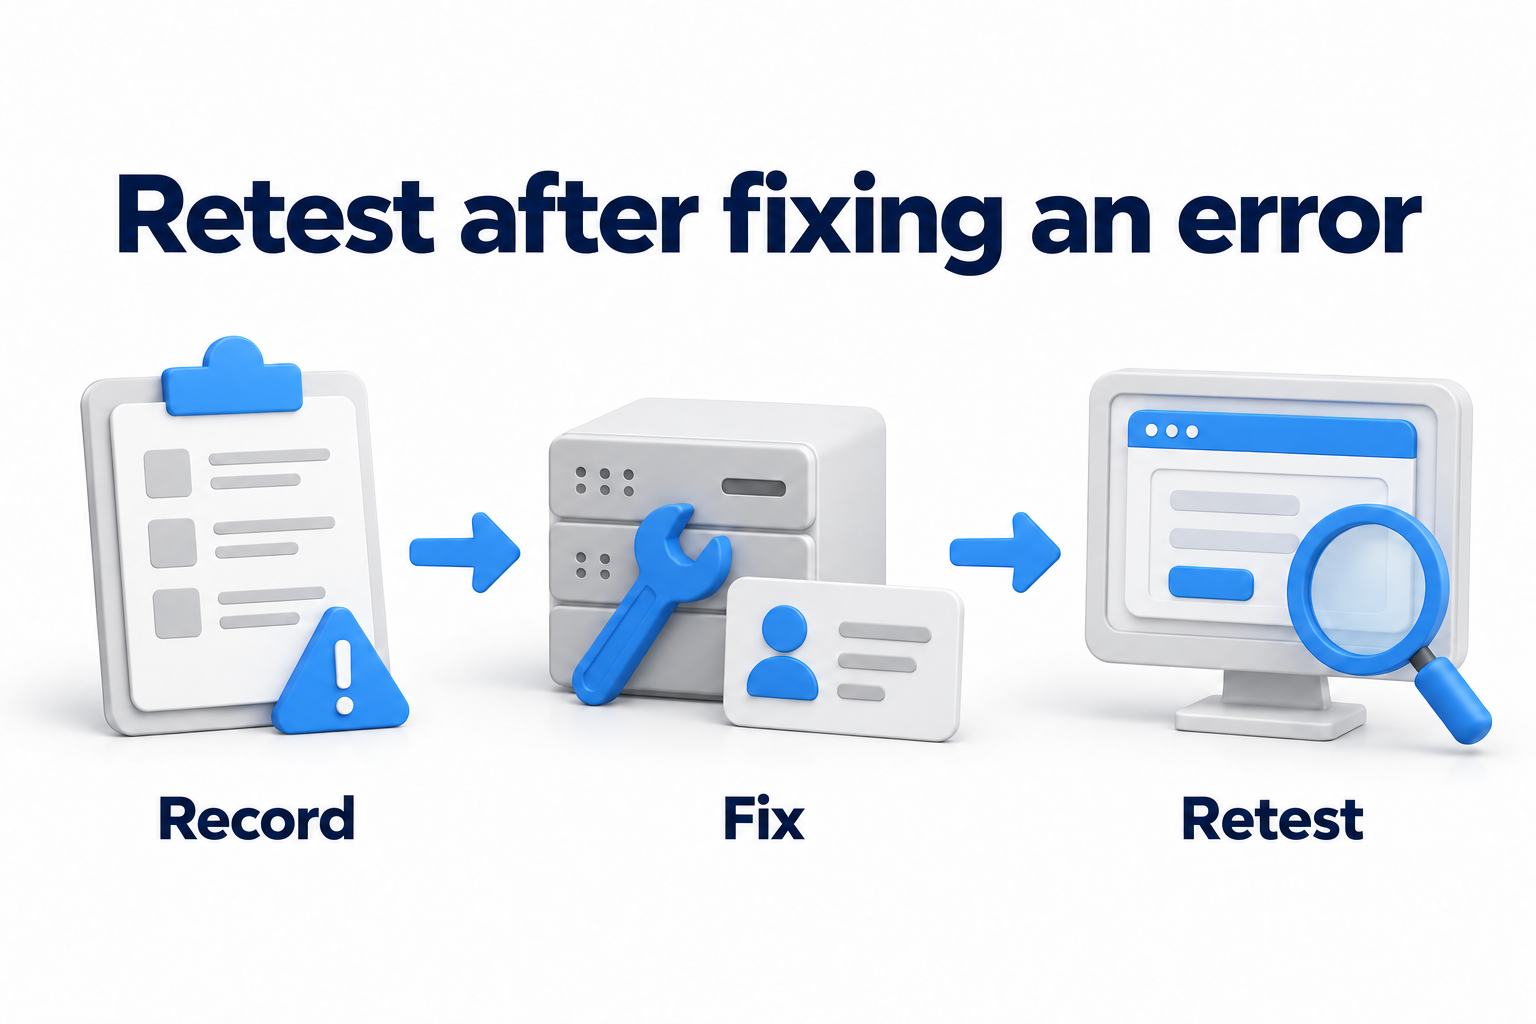
Revisar el resultado con los participantes. Distinguir entre la falta de recursos y los problemas relacionados con las instrucciones, el acceso y la coordinación. Asignar un responsable, una fecha límite y un criterio claro de solución para cada desviación significativa. Actualizar los procedimientos, los contactos y la configuración, y luego volver a probar la ruta modificada. Una nota que diga «tenido en cuenta» no cierra un error sin evidencia.
Demostrar la preparación de la gestión dentro del alcance probado: qué operaciones están confirmadas, dónde se han alcanzado los objetivos y qué sigue sin probar. La automatización puede recopilar tiempos, realizar pasos repetibles y mantener un registro. Sus escenarios, autoridad y resultados también necesitan verificación; no garantizan el éxito por sí mismos.
La criticidad, los cambios, los errores anteriores y los requisitos aplicables determinan la frecuencia. También planificar pruebas después de cambios significativos en el sistema, el sitio, los datos, el equipo o el proveedor. Una regla universal de que una vez al año es suficiente para todos ignora estas diferencias. Verificar si existen dependencias que cambien entre los ejercicios programados.
¿Necesita preparar o realizar una prueba de recuperación? Póngase en contacto con DKs Enterprises sobre respaldo y recuperación ante desastres. Proporcione el escenario, los criterios de acuerdo y los resultados anteriores para discutir el alcance del trabajo.