Планирование непрерывности бизнеса определяет, как поддерживать важные операции при нарушении обычных условий. Аварийное восстановление ИТ определяет, как вернуть в рабочее состояние необходимые системы, данные и технические зависимости. Эти задачи связаны, но различаются по охвату. Работающий сервер не поможет отправить заказ, если недоступны сотрудники или поставщик. Приём заказов по временной схеме не отменяет необходимости восстановить систему и сверить данные.
Выбор между BCP и DRP обычно сводится к названиям документов, а не к ответственности за результат. Вы можете документировать план непрерывности и план восстановления отдельно или в комплекте. Важно согласовать приоритеты, ответственных лиц и передачу решений.
Что охватывает каждая задача
BCP поддерживает важные бизнес-процессы
План обеспечения непрерывности бизнеса учитывает людей, помещения, оборудование, связь, поставщиков и операционные процедуры. Он определяет, какие операции должны продолжаться, в каком приемлемом объеме и с использованием временных методов. Это может включать альтернативное рабочее место, другой канал связи или согласованный ручной процесс. Убедитесь, что альтернативное решение работает, прежде чем вам это понадобится.
Непрерывность не гарантирует работу без каких-либо перебоев или потерь. Некоторые операции могут работать в ограниченном режиме, в то время как другие могут быть несовместимы. Руководство и владелец процесса должны понимать ограничения, доступные ресурсы и последствия временного решения.
План восстановления ИТ обеспечивает техническую возможность продолжения работы
План восстановления ИТ описывает, как восстановить или переключить необходимые приложения, данные, сетевые компоненты и зависимости. Для этого требуется последовательность действий, доступ к резервным копиям и ключам, доступная среда, назначенные роли и проверка результата. Резервная копия – это один ресурс, а не весь план.
Техническое восстановление должно соответствовать бизнес-задаче. Восстановление системы, которая не поддерживает приоритетный процесс, может привести к неэффективному использованию ресурсов. С другой стороны, критический процесс может зависеть от легко упускаемого из виду сервиса, интеграции или внешнего участника. Обе команды должны знать эти зависимости.
Руководство AWS рассматривает восстановление ИТ как часть более широкой стратегии обеспечения непрерывности бизнеса. Приоритеты и цели восстановления должны учитывать бизнес-задачу, риски и затраты. Техническая доступность сама по себе не учитывает последствия, выходящие за рамки приложения.
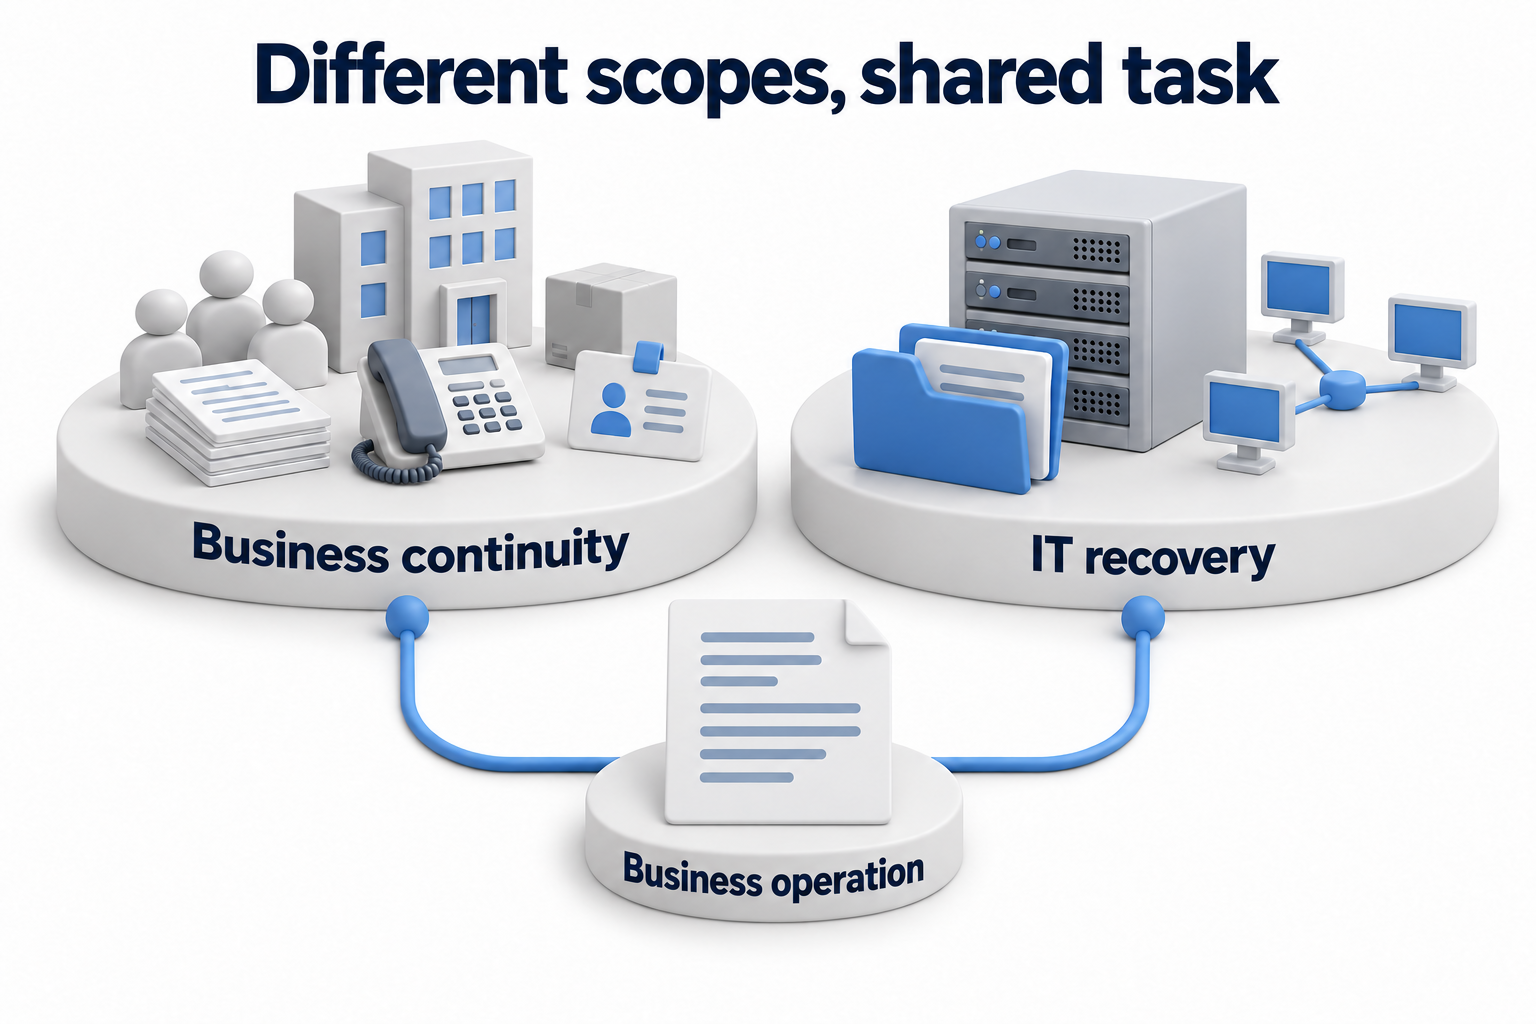
Сравните объем, ответственных лиц и критерии готовности
Различные границы в рамках единой скоординированной деятельности
|
Критерий |
Обеспечение непрерывности бизнеса |
Восстановление ИТ-систем после аварий |
|---|---|---|
|
Основной вопрос |
Как обеспечить бесперебойную работу при возникновении нештатных ситуаций |
Как восстановить технические ресурсы, необходимые для этой работы |
|
Область применения |
Люди, помещения, поставщики, средства связи, процедуры и зависимости от ИТ-систем |
Приложения, данные, инфраструктура, доступ и технические зависимости |
|
Ответственность |
Руководители и владельцы процессов, работающие с соответствующими отделами |
Технические команды, работающие с владельцами бизнес-результатов |
|
Временное решение |
Согласованный ограниченный режим работы или альтернативный процесс |
Восстановление, переключение или другое запланированное техническое мероприятие |
|
Исходные условия |
Приоритеты, допустимое влияние, ресурсы и ограничения |
Требования к процессу, согласованные уровни восстановления (RPO) и доступности (RTO), а также доступная среда и процедура |
|
Подтверждение результата |
Операция выполняется в согласованном режиме |
Технический результат и бизнес-операции проходят проверку |
|
Обновления |
Изменяются процессы, люди, местоположения или поставщики |
Изменяются системы, данные, зависимости или путь восстановления |
Подготовьте обе области до возникновения сбоя. Во время сбоя работа может продолжаться параллельно: бизнес организует допустимый временный режим работы, в то время как IT восстанавливает свою техническую инфраструктуру. Не предполагайте, что план BCP применим только до катастрофы или что DR начинается только после того, как кризис полностью закончится. Определите условия активации и координации в планах.
Как реагировать на киберинцидент
План реагирования на киберинциденты помогает выявить и оценить событие, ограничить его последствия и определить дальнейшие действия. Он дополняет планы восстановления и обеспечения непрерывности, но не заменяет их. Например, перед восстановлением приложения необходимо убедиться, что среда и выбранные данные безопасны для использования. Запуск технологий без этого соглашения может привести к повторению проблемы.
Неисправность оборудования без признаков атаки может потребовать других процедур. Не рассматривайте план реагирования на киберинциденты как универсальный основной документ для каждой ситуации с перебоями в работе. Текущая третья редакция руководства NIST связывает реагирование с более широким управлением киберрисками, включая подготовку, обнаружение, реагирование и восстановление.
Согласуйте планы через общую бизнес-задачу
Согласуйте приоритеты и приемлемый режим работы
Используйте результаты анализа влияния на бизнес: какие операции важны, кого затрагивает перебои, и как меняются последствия со временем. Эти данные поддерживают сравнение и координацию планов. Полный анализ рисков и расчет влияния требуют отдельной работы. Убедитесь, что обе команды используют одни и те же приоритеты.
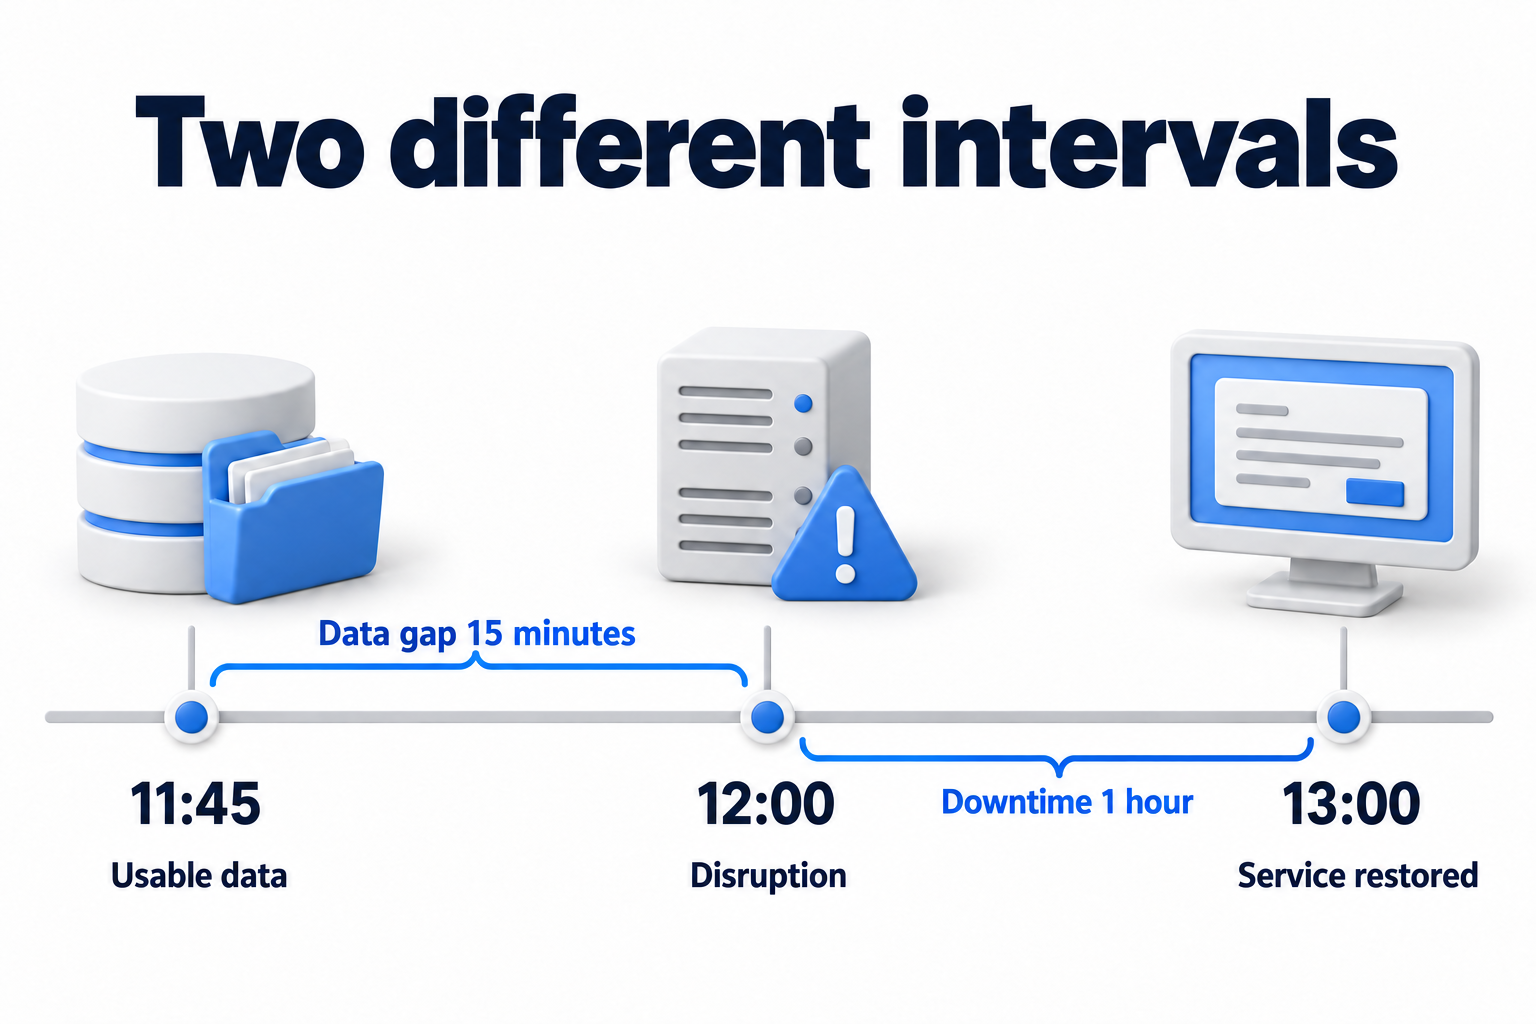
Для каждого важного процесса необходимо определить его владельца, технические зависимости и приемлемый временный способ работы. Цели RTO (Recovery Time Objective) и RPO (Recovery Point Objective) должны соответствовать этим условиям и технической реализуемости. В этой статье не предписываются универсальные временные рамки или заменяются отдельные решения о целях.
Зафиксируйте, кто активирует каждый набор действий, кто утверждает изменения приоритетов и кто получает подтверждение готовности. Включите резервных участников, внешние команды и канал связи для использования, когда нормальные инструменты не работают. Если контакты доступны только внутри потерянной системы, координация может остановиться вместе с ней.
Рассмотрите один гипотетический сценарий сбоя
Предположим, основной сайт недоступен, и сотрудники не могут использовать систему обработки заказов. Следующий гипотетический сценарий проверяет границы ответственности. Это не готовая процедура для вашей компании. Подтвердите возможность временного приема заказов и метод восстановления для вашей среды.
Координированный гипотетический сценарий недоступности сайта
|
Этап |
Действия по обеспечению непрерывности |
Действия по восстановлению ИТ |
Точка координации |
|---|---|---|---|
|
Оценка влияния |
Ответственный за процесс определяет затронутые операции и допустимый уровень производительности |
Команда определяет недоступные компоненты и необходимые зависимости |
Руководство подтверждает приоритеты и активирует запланированные действия |
|
Временные операции |
Команда использует утвержденный альтернативный канал и фиксирует поступающие запросы |
ИТ подготавливает необходимую среду и извлекает полезные данные |
Участники знают ограничения, ответственных лиц и время следующего обновления статуса |
|
Техническое восстановление |
Ответственный готовит тестовую версию необходимой бизнес-операции |
ИТ восстанавливает систему и проверяет данные, доступ и соединения |
Принятие решения зависит от функциональности, а не только от запуска сервера. |
|
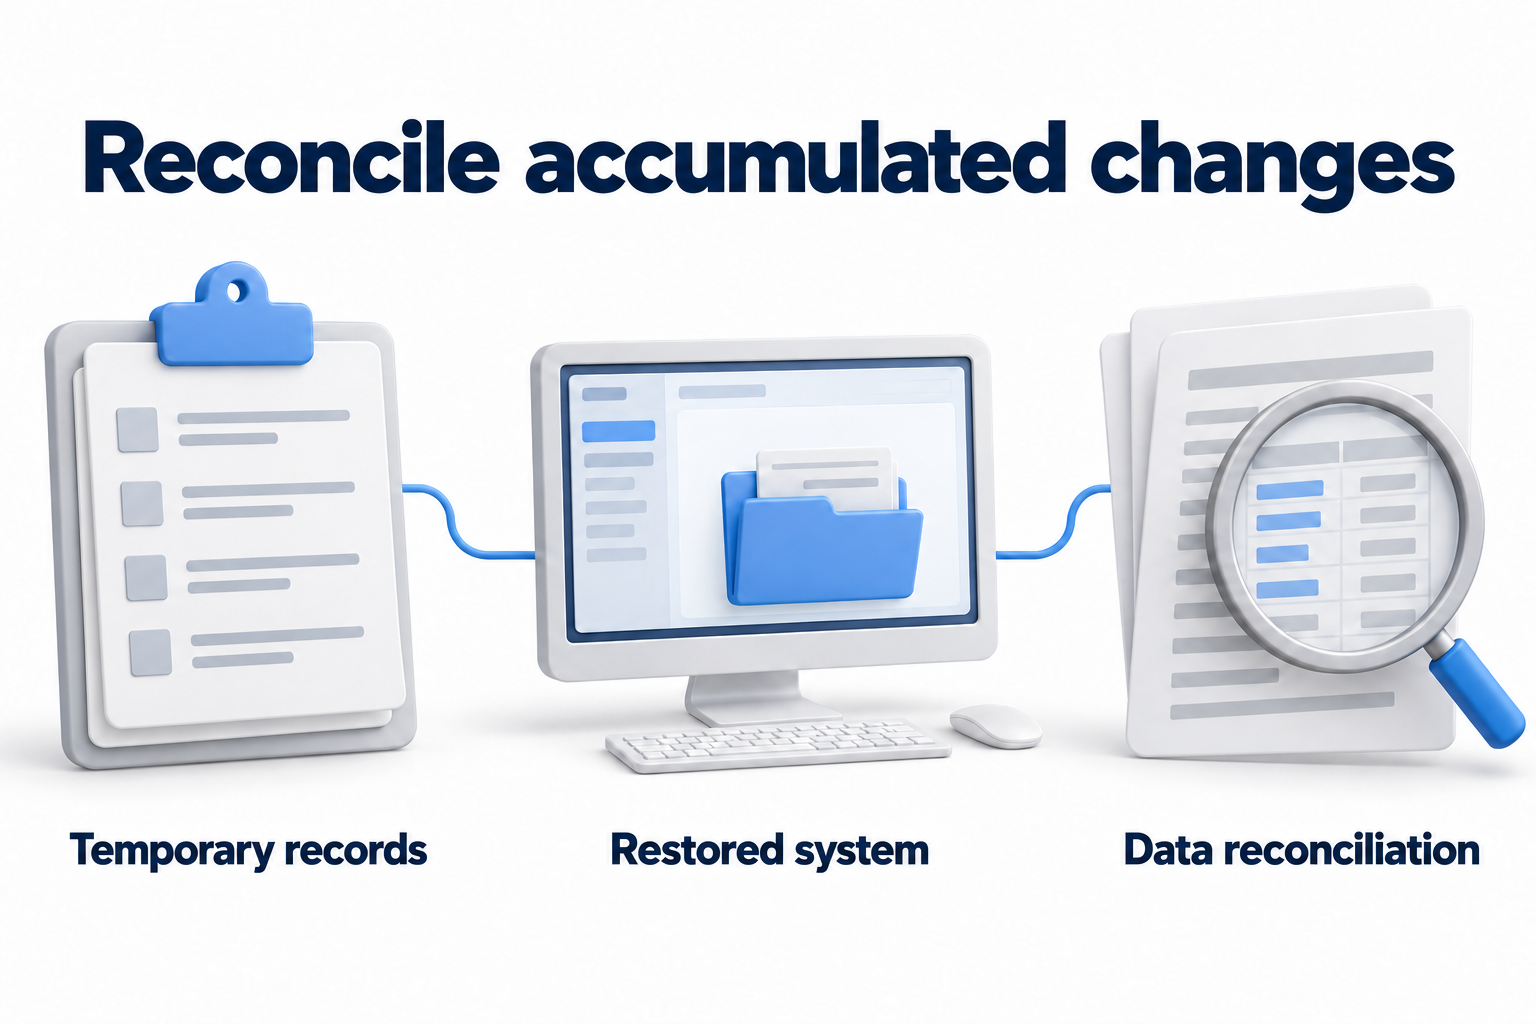
Сопоставление и сверка накопленных записей |
Назначенные ответственные лица сравнивают запросы и изменения, возникшие в переходный период. |
IT-поддержка обеспечивает применение согласованного процесса передачи и проверки. |
Ни одна запись не теряется, не возникают дубликаты, а спорные данные передаются ответственному лицу. |
|
Возврат к нормальной работе |
Ответственное лицо подтверждает завершение переходных операций и информирует участников. |
Команда завершает согласованный переход и проверяет нормальную защиту. |
Подтверждаются бизнес-результаты, оставшиеся ограничения и дальнейшие действия. |
Если аналогичная ситуация включает признаки атаки, необходимо также координироваться с ответственными лицами по вопросам кибербезопасности. Нельзя просто полагаться на запуск системы, чтобы восстановить доверие. Если ручное вмешательство неприемлемо, это также следует зафиксировать. В этом случае, вы не можете гарантировать его как универсальную замену IT-поддержке.
Проверьте пробелы на границах ответственности
- Бизнес ожидает, что операция будет доступна, но техническая проверка ограничивается только запуском инфраструктуры.
- Существует временный способ работы, но полномочия, ограничения и ответственный не определены.
- Приоритеты процесса и последовательность восстановления системы не совпадают.
- Не учтен внешний сервис, поставщик, канал связи или участник резервного копирования.
- Никто не отвечает за сверку новых временных данных с восстановленной системой.
- Команда не знает, кто принимает результат и дает разрешение на возврат.
- Контакты, инструкции и доказательства существуют только в недоступной среде.
Облачная инфраструктура, резервирование и автоматизация могут поддерживать восстановление, но они не решают все проблемы, связанные с людьми, ресурсами и бизнес-решениями. Выберите ресурсы для согласованного сценария. Покупка продукта с маркировкой BCDR не устанавливает границы ответственности или критерии принятия бизнеса.
Координация тестирования и принятие решений об обновлении
Начните совместный анализ с выбранной операцией: кто принимает решения, как работает временная работа, что восстанавливает IT и кто подтверждает завершение. Работа над сценарием помогает выявить неясные моменты. Проведите фактическое восстановление отдельно в рамках согласованного объема. Обсуждение за столом само по себе не доказывает техническую готовность.
После анализа сохраните выявленные пробелы, ответственных за устранение, и условия для повторного тестирования. Проанализируйте взаимосвязь между планами после изменений в процессе, команде, системе, поставщике или объекте. Частота зависит от рисков и применимых требований, а не от общего утверждения, что ежегодный анализ достаточно для любого бизнеса.
В качестве следующего шага, создайте краткую карту одной операции: владелец, допустимый режим работы, зависимости от ИТ, цели, временные данные, принятие и возврат. Это покажет, что требует согласования. Разработайте полные шаблоны BCP и DRP, инструкции по восстановлению и записи о тренировках для конкретных условий.
Нужно проверить, соответствует ли план восстановления ИТ-систем приоритетам бизнеса? Обратитесь в DKs Enterprises. резервное копирование и восстановление после аварий. Составьте список важных операций, технических зависимостей и известных проблем, чтобы определить объем работ.